Batch Normalization thường xuất hiện trong Deep Learning và CNN. HD Agency sẽ giúp bạn hiểu BatchNorm là gì, cách chuẩn hóa dữ liệu và sự khác nhau giữa training và inference.
Batch Normalization là gì?
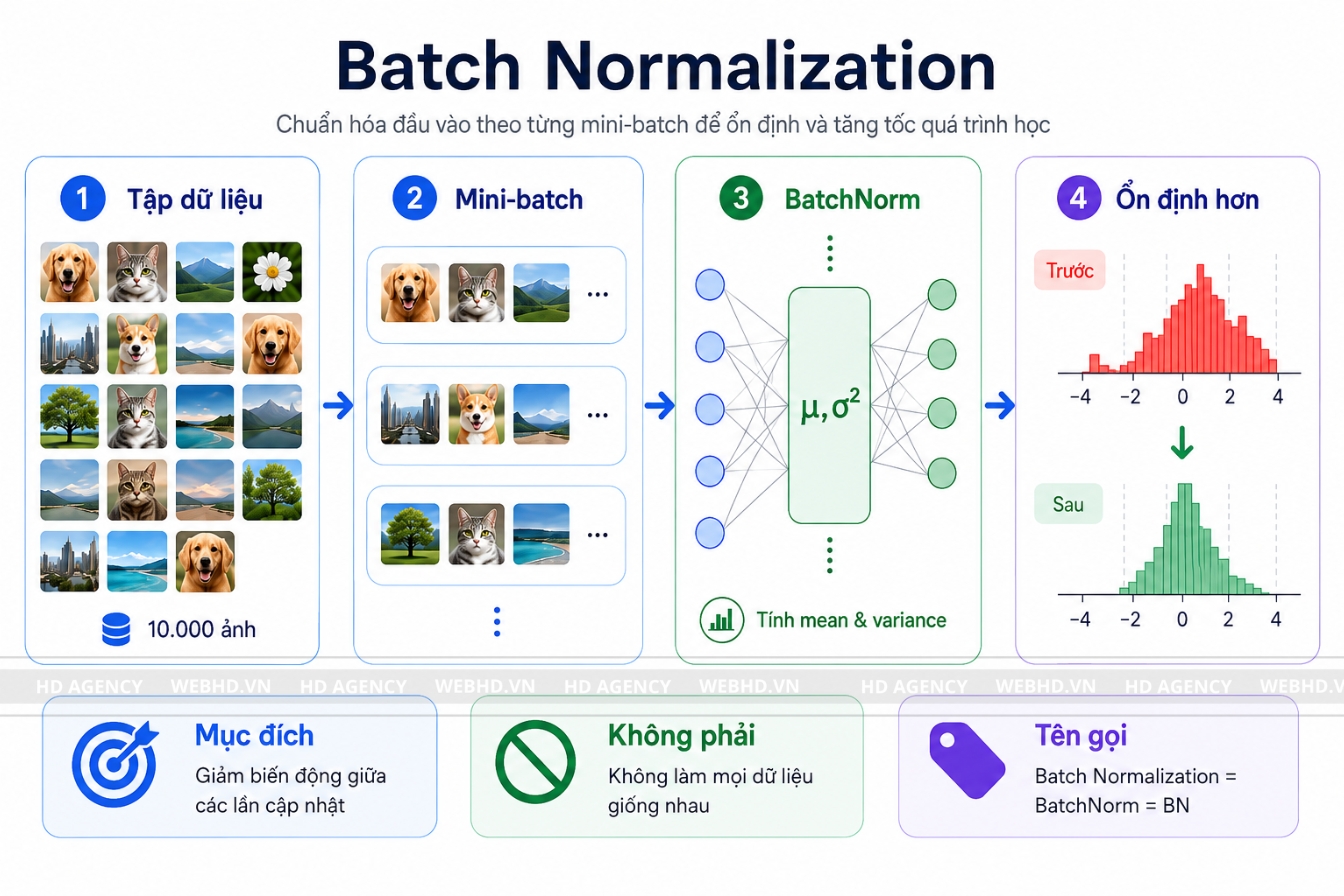
Batch Normalization là kỹ thuật chuẩn hóa các giá trị được tạo ra bên trong mạng nơ-ron dựa trên một nhóm dữ liệu nhỏ đang được xử lý.
Nhóm dữ liệu nhỏ đó được gọi là mini-batch, tức một phần dữ liệu được đưa vào mô hình trong mỗi lần tính toán.
Ví dụ, chúng ta có 10.000 hình ảnh để huấn luyện mô hình. Thay vì đưa cả 10.000 ảnh vào cùng lúc, hệ thống có thể chia thành từng nhóm 32 hoặc 64 ảnh. Batch Normalization sẽ dựa vào các giá trị của nhóm dữ liệu đó để thực hiện bước chuẩn hóa.
Mục đích của BatchNorm không phải làm cho mọi dữ liệu giống nhau, mà giúp các giá trị bên trong mạng không thay đổi quá thất thường giữa các lần cập nhật.
Các doanh nghiệp đang phát triển nội dung chuyên sâu về AI, Machine Learning hoặc công nghệ, việc giải thích đúng những thuật ngữ như Batch Normalization cũng ảnh hưởng trực tiếp đến chất lượng nội dung website. HD Agency hiện cung cấp dịch vụ SEO, hỗ trợ xây dựng cấu trúc nội dung theo chủ đề, tối ưu từ khóa và cải thiện khả năng tiếp cận người dùng từ Google mà không dựa vào việc lặp từ khóa quá nhiều.
Nếu bạn đang tìm kiếm cụm từ batchnormalization là gì, thì đây thực chất chỉ là cách viết liền của Batch Normalization. Trong tài liệu kỹ thuật, tên thường được sử dụng là Batch Normalization, BatchNorm hoặc BN.
Normalization là gì?
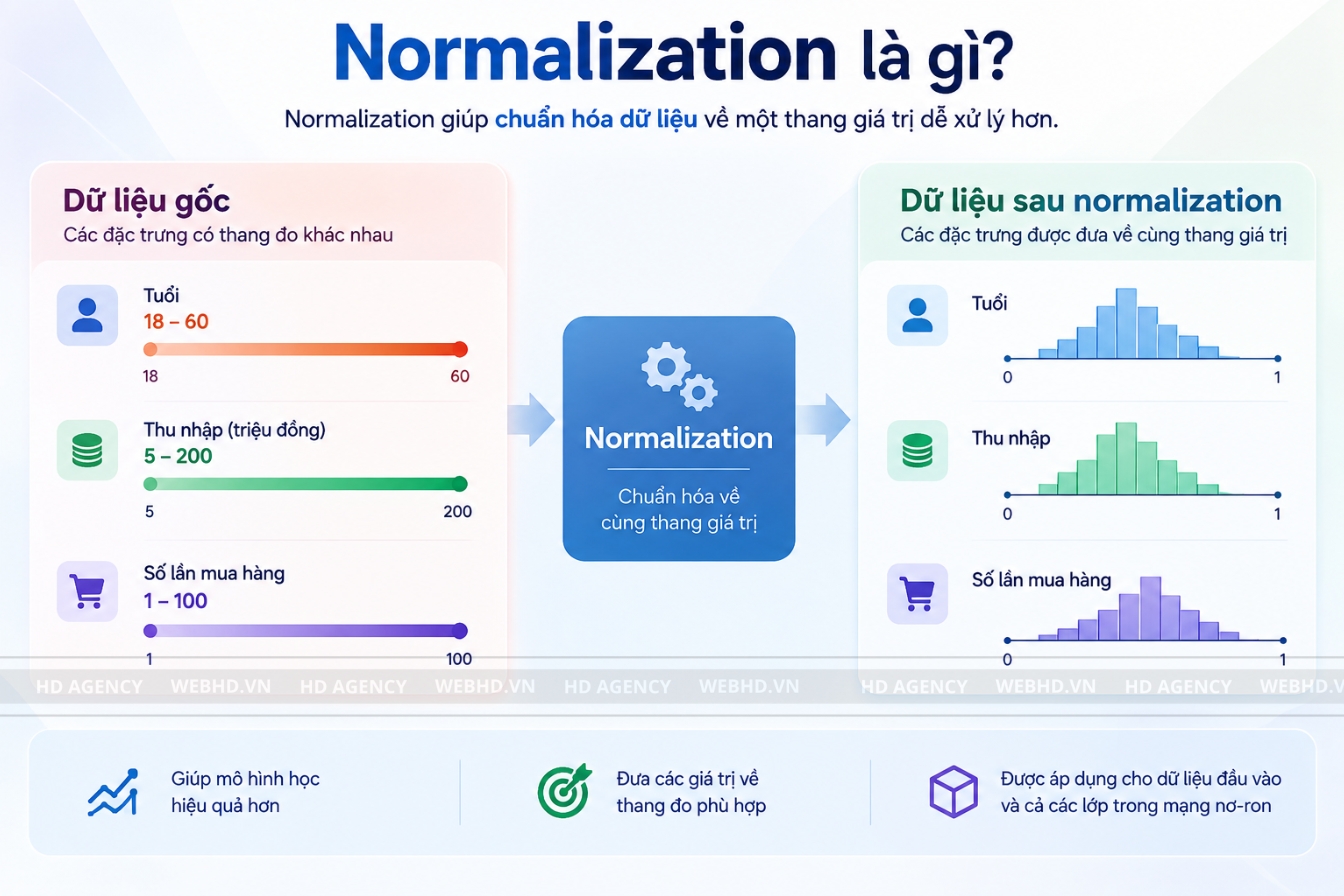
Normalization có thể hiểu đơn giản là chuẩn hóa dữ liệu về một thang giá trị dễ xử lý hơn.
Ví dụ, một tập dữ liệu có:
- Tuổi từ 18 đến 60
- Thu nhập từ 5 triệu đến 200 triệu đồng
- Số lần mua hàng từ 1 đến 100
Nếu đưa trực tiếp những giá trị có thang đo rất khác nhau vào một số thuật toán Machine Learning, việc học có thể trở nên khó khăn hơn.
Normalization giúp điều chỉnh các giá trị đó về những khoảng phù hợp hơn.
Trong Deep Learning, normalization không chỉ được thực hiện với dữ liệu đầu vào. Nó còn có thể được áp dụng cho các giá trị sinh ra tại từng lớp của mạng nơ-ron.
Batch Normalization chính là một trong những kỹ thuật thuộc nhóm này.
Batch Normalization hoạt động như thế nào?
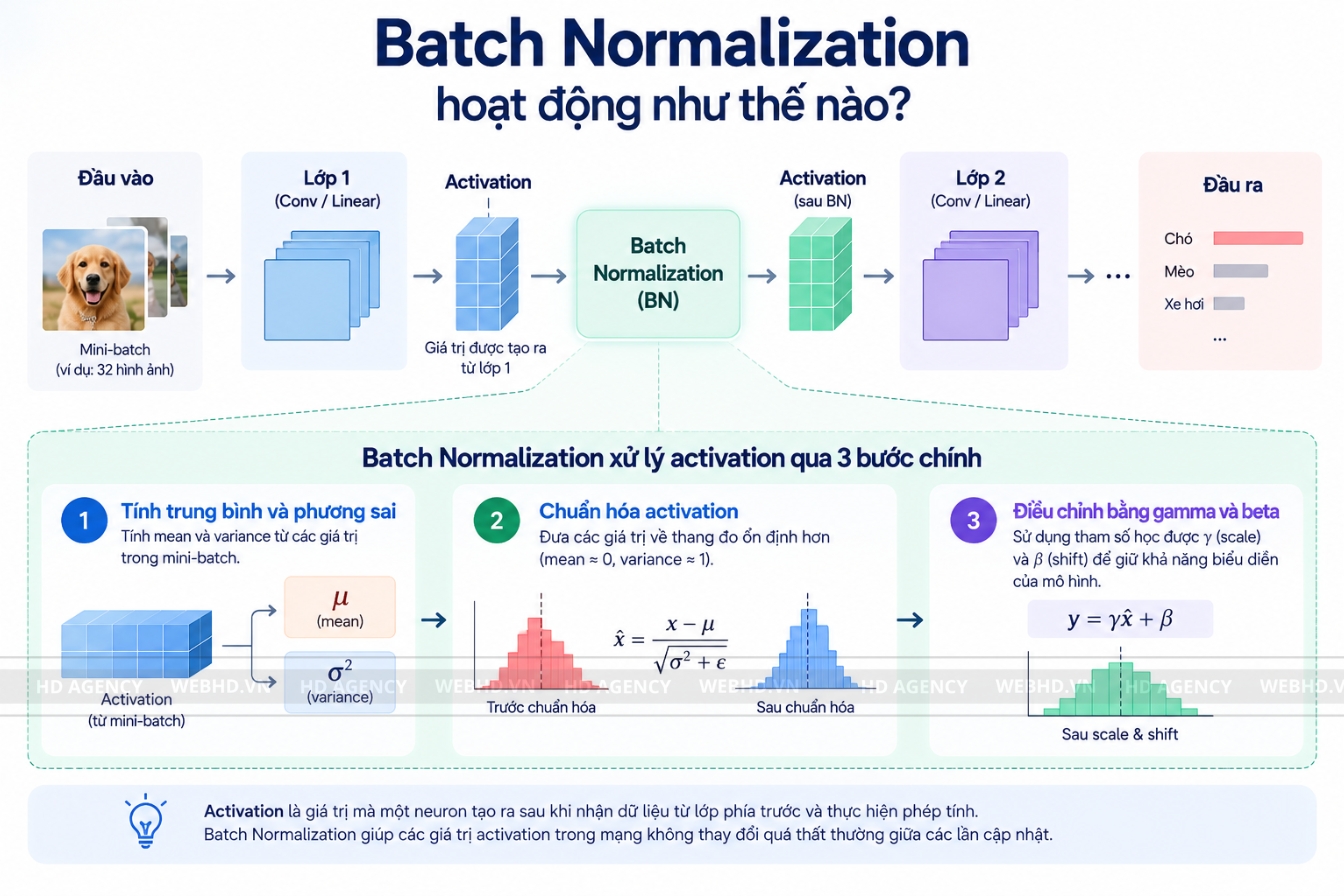
Để hiểu cách Batch Normalization hoạt động, trước tiên cần biết một khái niệm là activation.
Activation là giá trị mà một neuron tạo ra sau khi nhận dữ liệu từ lớp phía trước và thực hiện phép tính.
Có thể hình dung mạng nơ-ron gồm nhiều lớp. Mỗi lớp nhận dữ liệu, xử lý rồi chuyển kết quả sang lớp tiếp theo. Những kết quả trung gian đó chính là activation.
BatchNorm xử lý activation qua ba bước chính.
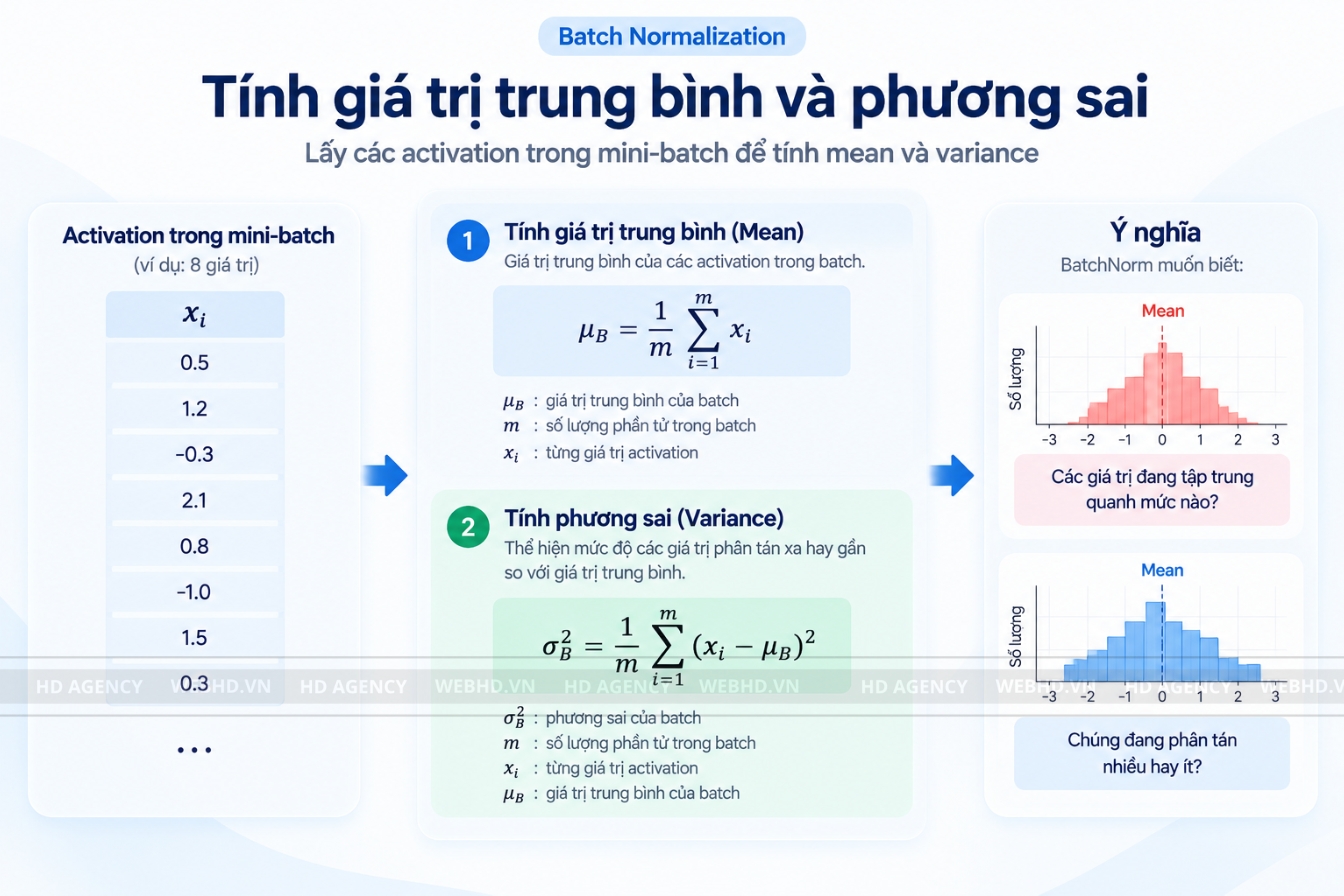
Tính giá trị trung bình và phương sai
Đầu tiên, hệ thống lấy các activation trong mini-batch để tính hai thông số:
Mean là giá trị trung bình.
Variance là phương sai, dùng để thể hiện mức độ các giá trị phân tán xa hay gần so với giá trị trung bình.
Công thức trung bình:
μB = (1/m) Σ xi
Trong đó:
- μB là giá trị trung bình của batch
- m là số lượng phần tử
- xi là từng giá trị trong batch
Sau đó hệ thống tính variance:
σ²B = (1/m) Σ (xi – μB)²
Người không làm kỹ thuật không nhất thiết phải ghi nhớ hai công thức này. Điểm cần hiểu là BatchNorm muốn biết:
- Các giá trị đang tập trung quanh mức nào?
- Chúng đang phân tán nhiều hay ít?
Từ đó mới có thể thực hiện bước chuẩn hóa.
Chuẩn hóa các giá trị
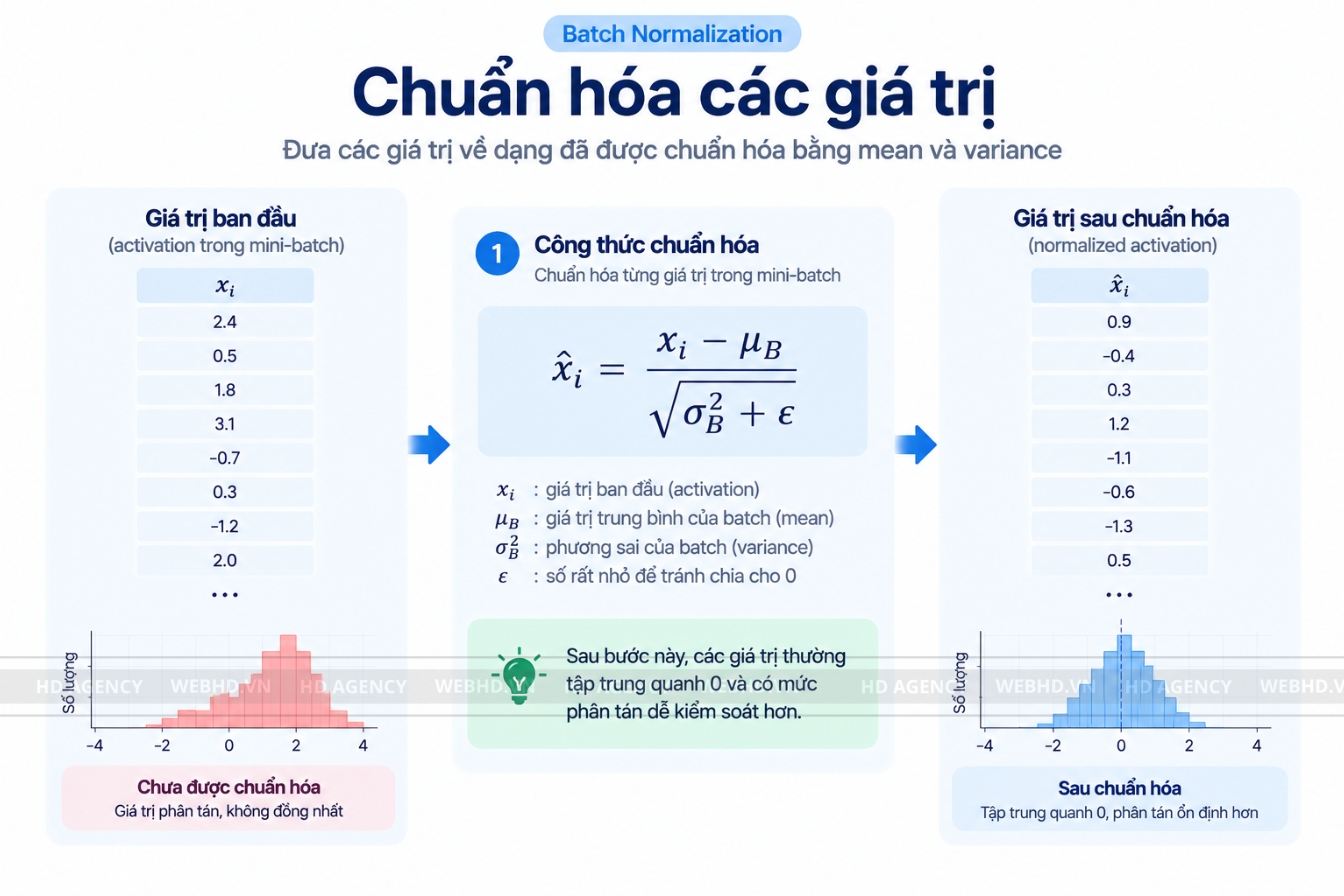
Sau khi có mean và variance, BatchNorm đưa mỗi giá trị về một dạng đã được chuẩn hóa:
x̂i = (xi – μB) / √(σ²B + ε)
Trong công thức này, epsilon, ký hiệu là ε, là một số rất nhỏ được thêm vào để tránh trường hợp phép chia gặp vấn đề khi variance quá nhỏ hoặc bằng 0.
Sau bước này, các giá trị thường có xu hướng tập trung quanh 0 và có mức phân tán dễ kiểm soát hơn.
Điều chỉnh bằng gamma và beta
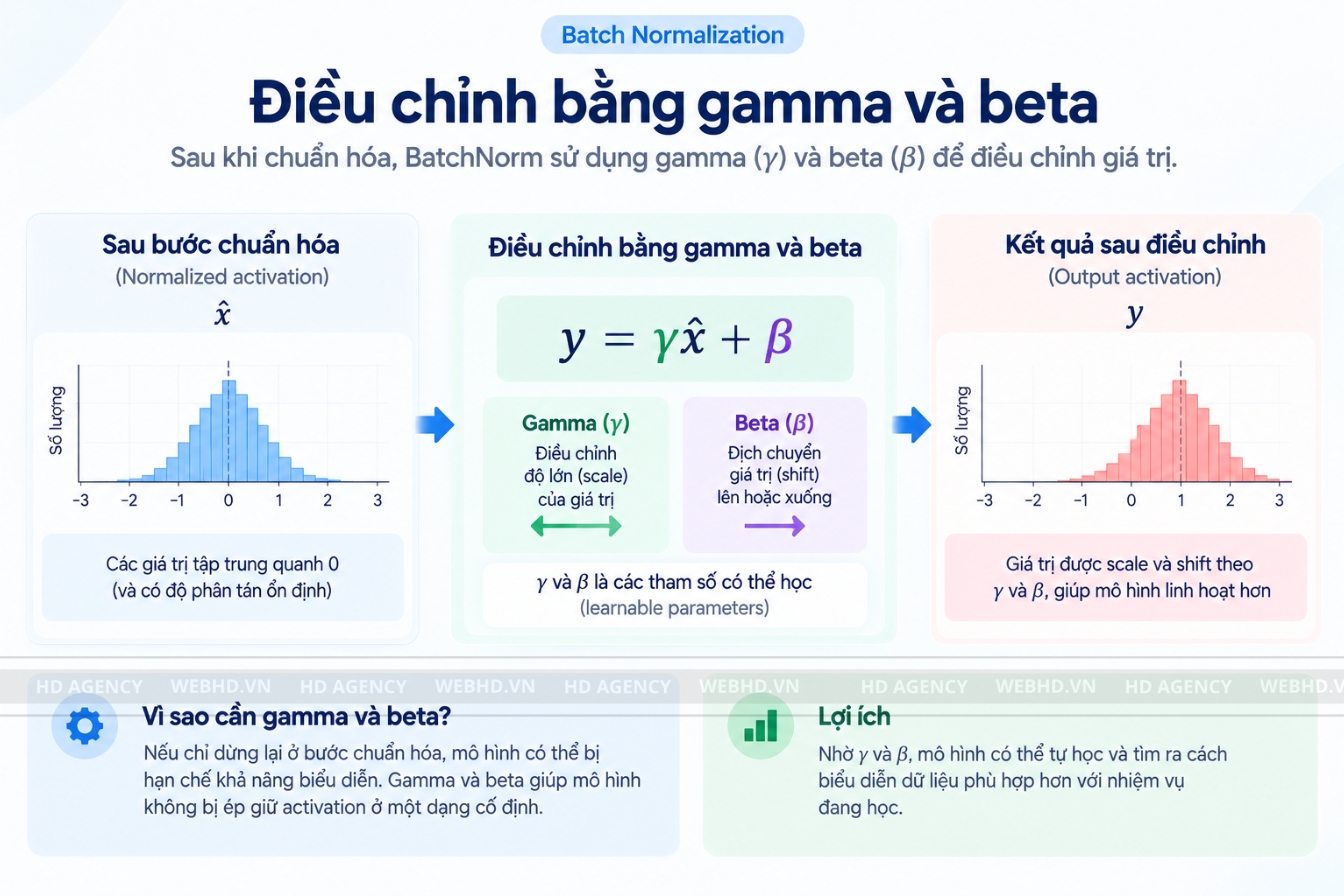
Nếu BatchNorm chỉ dừng lại ở bước chuẩn hóa thì khả năng biểu diễn của mạng có thể bị hạn chế.
Vì vậy, kỹ thuật này sử dụng thêm hai tham số:
Gamma, ký hiệu γ, dùng để điều chỉnh độ lớn của giá trị.
Beta, ký hiệu β, dùng để dịch chuyển giá trị lên hoặc xuống.
Công thức:
y = γx̂ + β
Gamma và beta được gọi là learnable parameters, tức các tham số mà mô hình có thể tự học khi huấn luyện.
Nhờ vậy, mô hình không bị ép phải giữ activation ở một dạng cố định. Nó vẫn có thể tự tìm ra cách biểu diễn dữ liệu phù hợp với nhiệm vụ đang học.
Batch size là gì?
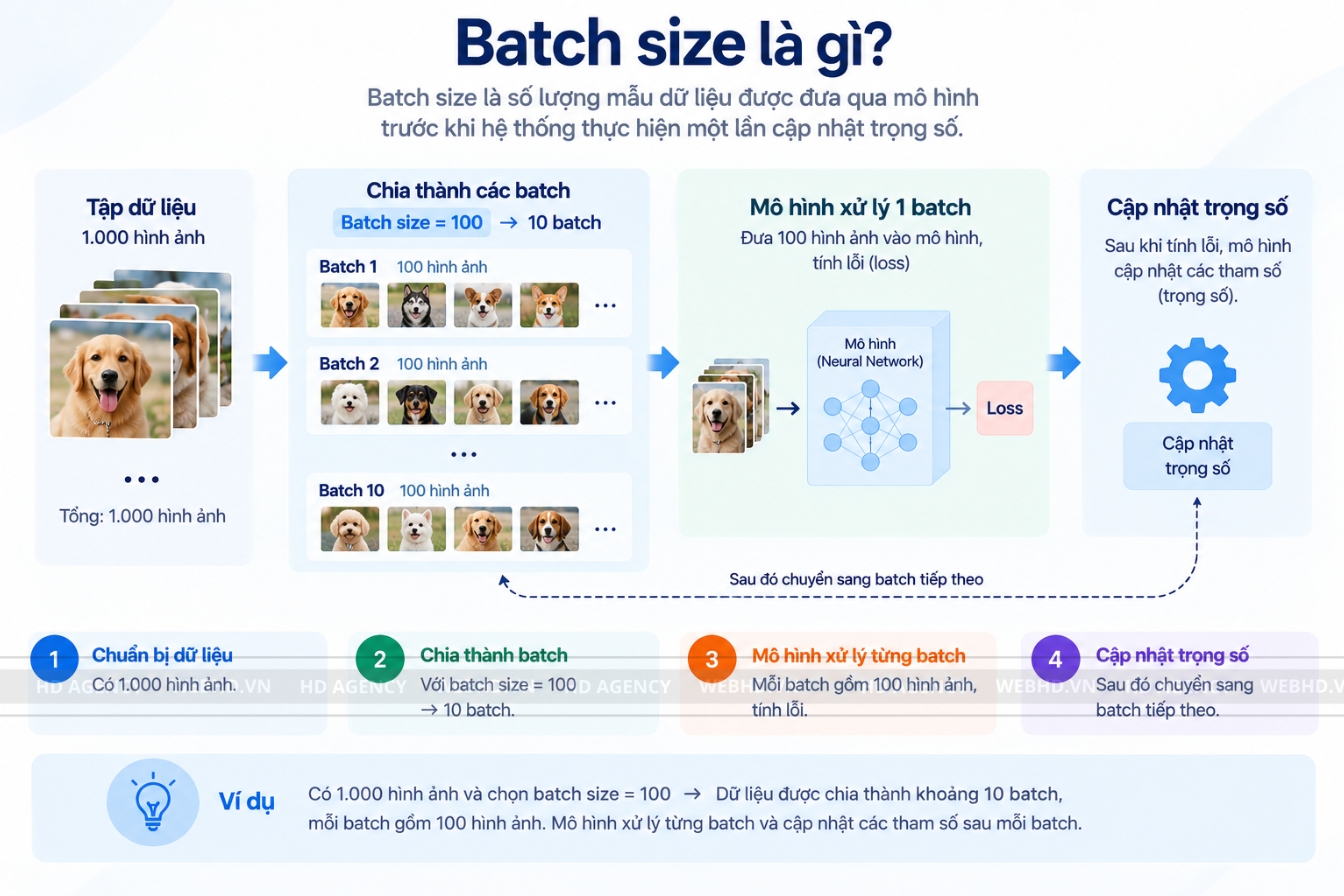
Batch size là số lượng mẫu dữ liệu được đưa qua mô hình trước khi hệ thống thực hiện một lần cập nhật trọng số.
Ví dụ có 1.000 hình ảnh và chọn:
Batch size = 100
Khi đó, dữ liệu được chia thành khoảng 10 batch.
Mỗi batch gồm 100 hình ảnh. Mô hình xử lý 100 hình ảnh này, tính lỗi rồi cập nhật các tham số.
Sau đó mới chuyển sang batch tiếp theo.
Batch size có liên quan gì đến Batch Normalization?
Mối liên hệ nằm ngay trong tên gọi.
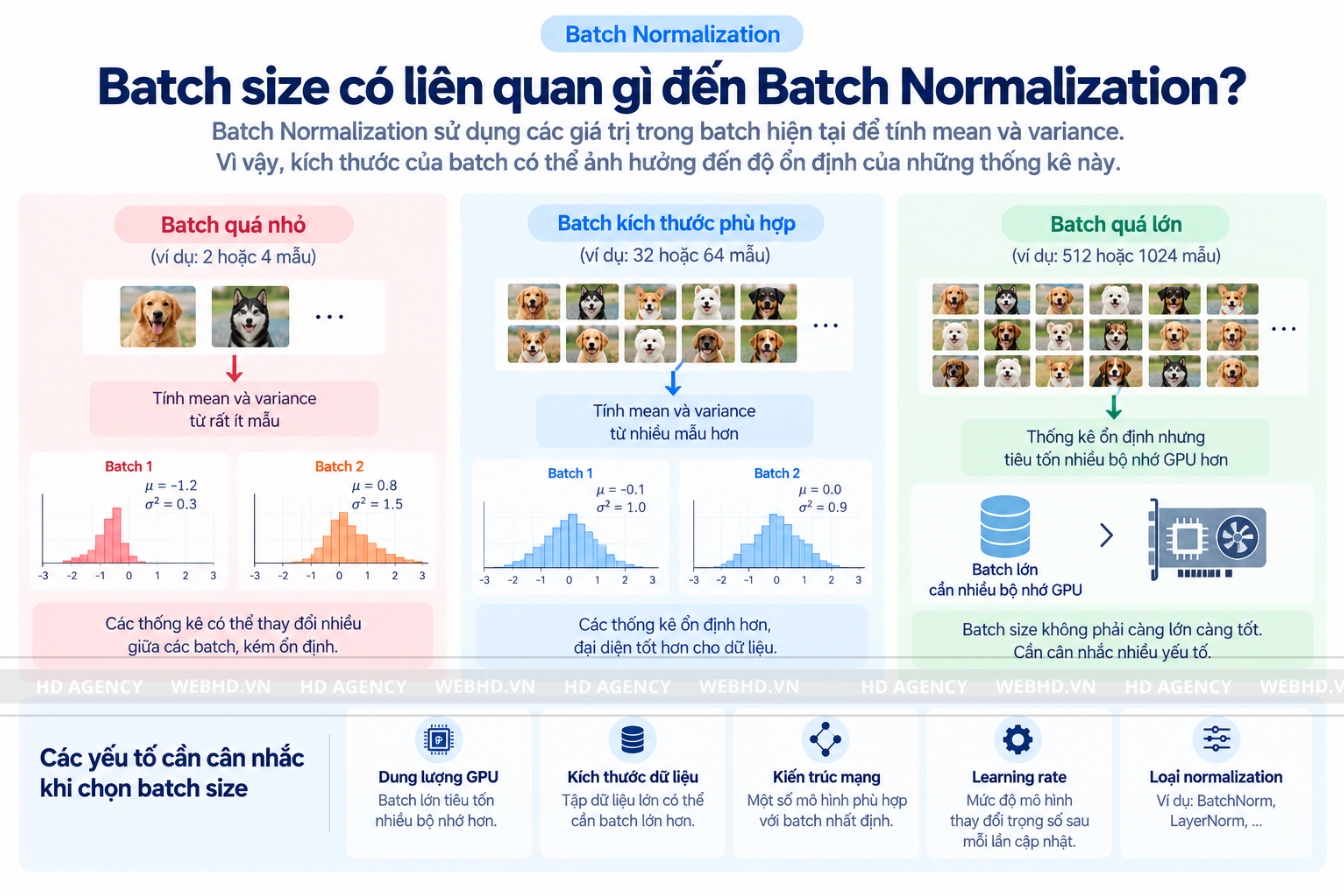
Batch Normalization sử dụng các giá trị trong batch hiện tại để tính mean và variance. Vì vậy, kích thước của batch có thể ảnh hưởng đến độ ổn định của những thống kê này.
Nếu batch quá nhỏ, chẳng hạn chỉ có 2 hoặc 4 mẫu, các giá trị trong batch có thể không đại diện tốt cho toàn bộ dữ liệu.
Khi đó, mean và variance có thể thay đổi khá mạnh giữa các batch.
Nếu batch có kích thước phù hợp, các thống kê thường ổn định hơn.
Tuy nhiên, điều này không có nghĩa batch size càng lớn càng tốt. Batch lớn tiêu tốn nhiều bộ nhớ GPU hơn và còn ảnh hưởng đến cách mô hình học.
Vì vậy, batch size cần được lựa chọn dựa trên:
- Dung lượng GPU
- Kích thước dữ liệu
- Kiến trúc mạng
- Learning rate
- Loại normalization đang sử dụng
Trong đó, learning rate là mức độ mô hình thay đổi trọng số sau mỗi lần cập nhật.
Batch Normalization khác nhau thế nào khi training và inference?
Đây là phần khá quan trọng nhưng nhiều bài giải thích chưa rõ.
Một mô hình AI thường có hai trạng thái chính:
Training là giai đoạn mô hình đang học từ dữ liệu.
Inference là giai đoạn mô hình đã học xong và được dùng để dự đoán dữ liệu mới.
Ví dụ, khi huấn luyện hệ thống nhận dạng chó và mèo, đó là training.
Khi người dùng tải một bức ảnh lên và hệ thống trả lời đó là chó hay mèo, đó là inference.
Khi training
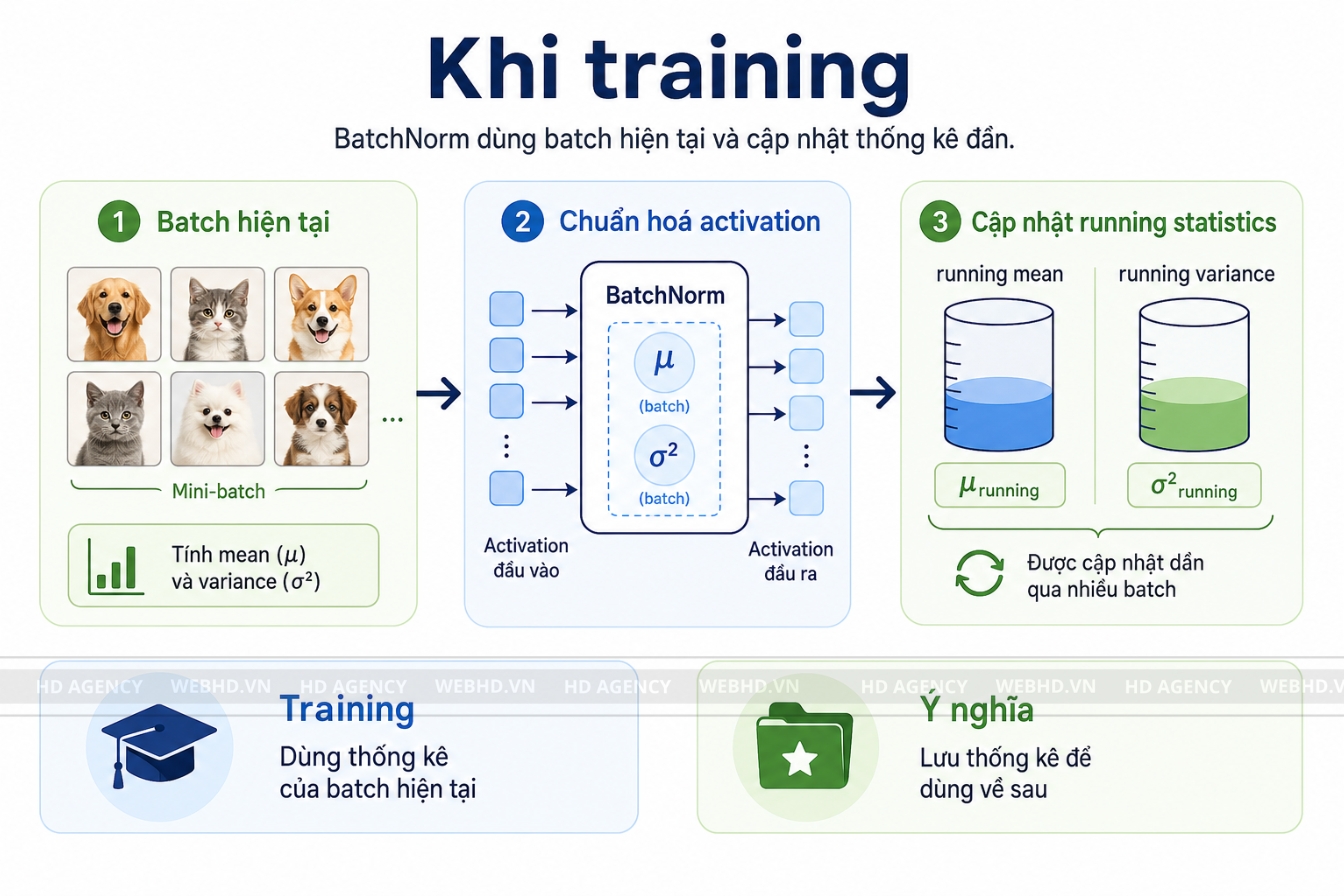
Batch Normalization tính mean và variance từ batch hiện tại.
Đồng thời, hệ thống lưu lại các giá trị trung bình tích lũy qua nhiều batch. Các giá trị này thường được gọi là running mean và running variance.
Có thể hiểu đơn giản đây là thống kê được cập nhật dần khi mô hình học.
Khi inference
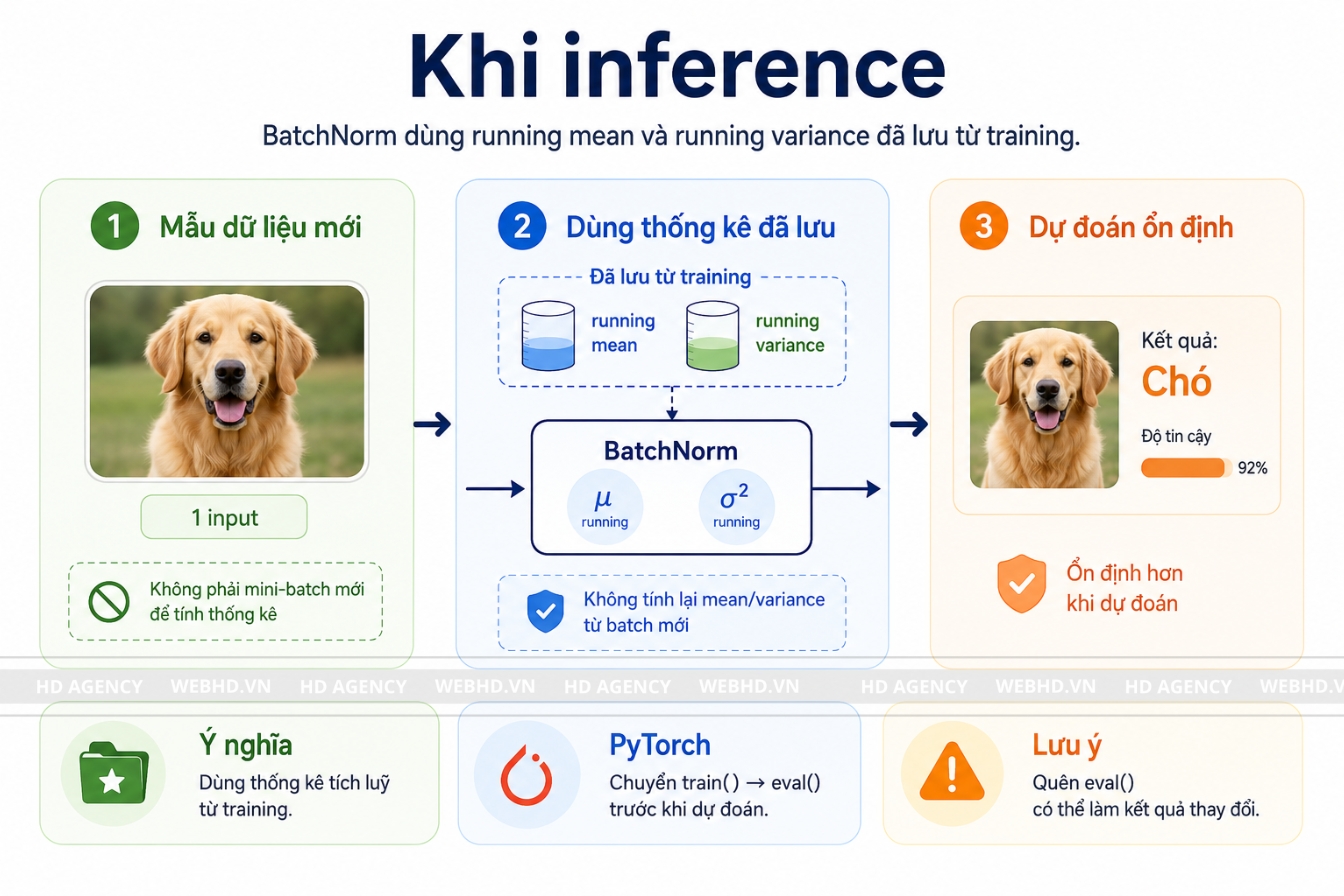
Ở chế độ inference, BatchNorm thông thường không dựa vào một batch mới để tính lại mean và variance.
Thay vào đó, hệ thống sử dụng running mean và running variance đã tích lũy khi training.
Cách làm này giúp kết quả dự đoán ổn định hơn, đặc biệt khi người dùng chỉ đưa một mẫu dữ liệu vào mô hình.
Trong PyTorch, lập trình viên thường chuyển mô hình từ train() sang eval() trước khi chạy dự đoán.
Nếu quên bước này, BatchNorm có thể hoạt động khác với mong đợi và làm kết quả thay đổi.
Vì sao Batch Normalization giúp mô hình học ổn định hơn?
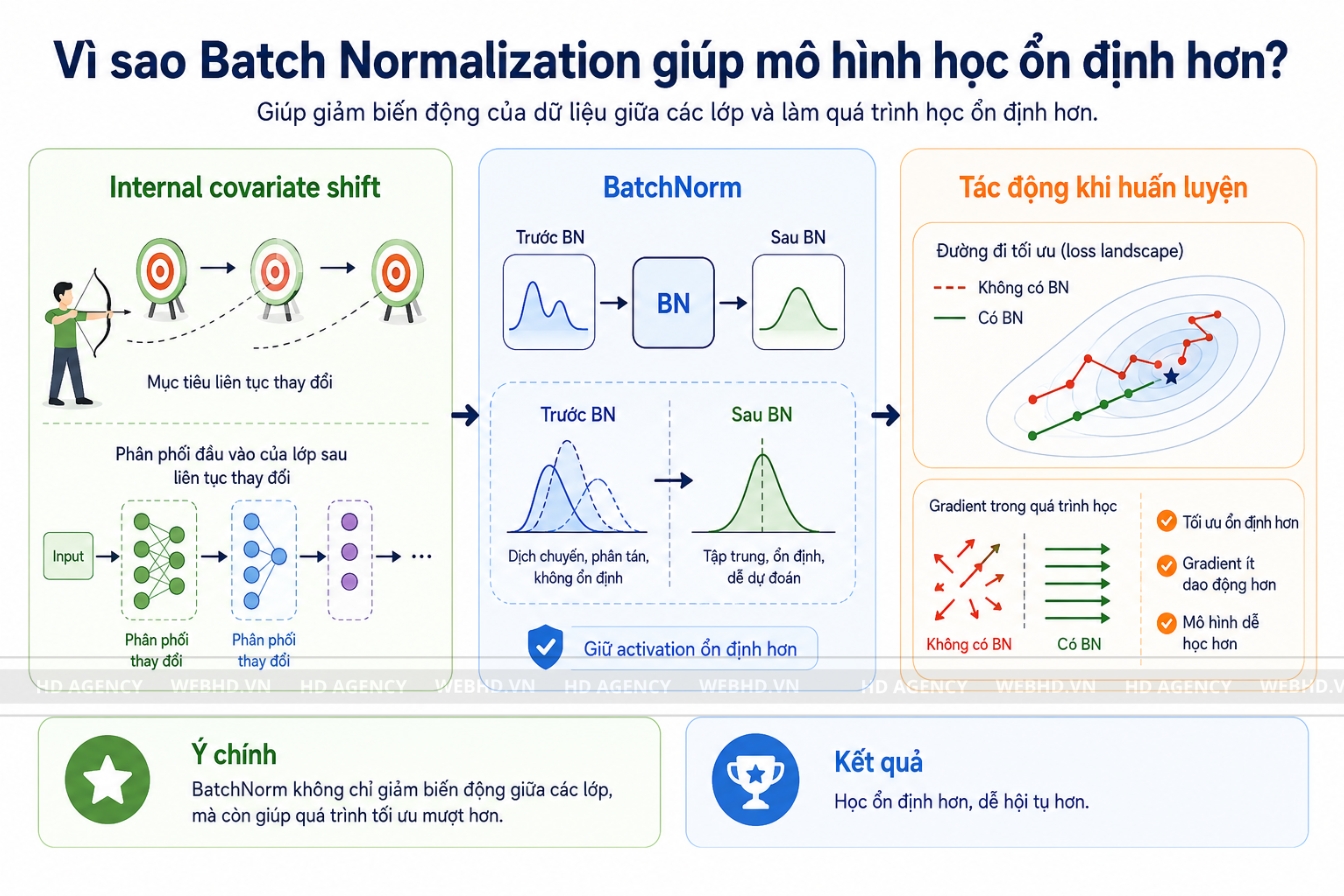
Khi BatchNorm được giới thiệu năm 2015, nhóm tác giả cho rằng kỹ thuật này giúp giảm hiện tượng internal covariate shift.
Thuật ngữ này chỉ việc phân phối dữ liệu đầu vào của một lớp liên tục thay đổi do các lớp phía trước cũng đang cập nhật trọng số.
Nói đơn giản hơn, hãy tưởng tượng bạn đang cố học bắn vào một mục tiêu, nhưng sau mỗi lần bắn thì mục tiêu lại di chuyển sang vị trí khác.
Việc học sẽ khó hơn.
Trong mạng nơ-ron, các lớp phía trước liên tục thay đổi khiến dữ liệu mà lớp phía sau nhận được cũng thay đổi theo.
Ban đầu, đây được xem là lý do chính khiến BatchNorm có hiệu quả.
Tuy nhiên, các nghiên cứu sau đó cho thấy câu chuyện không đơn giản như vậy.
Một nghiên cứu được công bố tại NeurIPS năm 2018 cho rằng lợi ích của BatchNorm không thể giải thích đầy đủ chỉ bằng việc giảm internal covariate shift.
Nghiên cứu này chỉ ra rằng BatchNorm còn giúp quá trình tối ưu trở nên ổn định hơn.
Ở đây, optimization là quá trình mô hình liên tục điều chỉnh trọng số để giảm lỗi dự đoán.
BatchNorm có thể giúp gradient hoạt động ổn định hơn.
Gradient là thông tin cho mô hình biết trọng số nên thay đổi theo hướng nào để giảm lỗi.
Khi gradient ổn định, mô hình thường dễ học hơn.
Ưu điểm của Batch Normalization
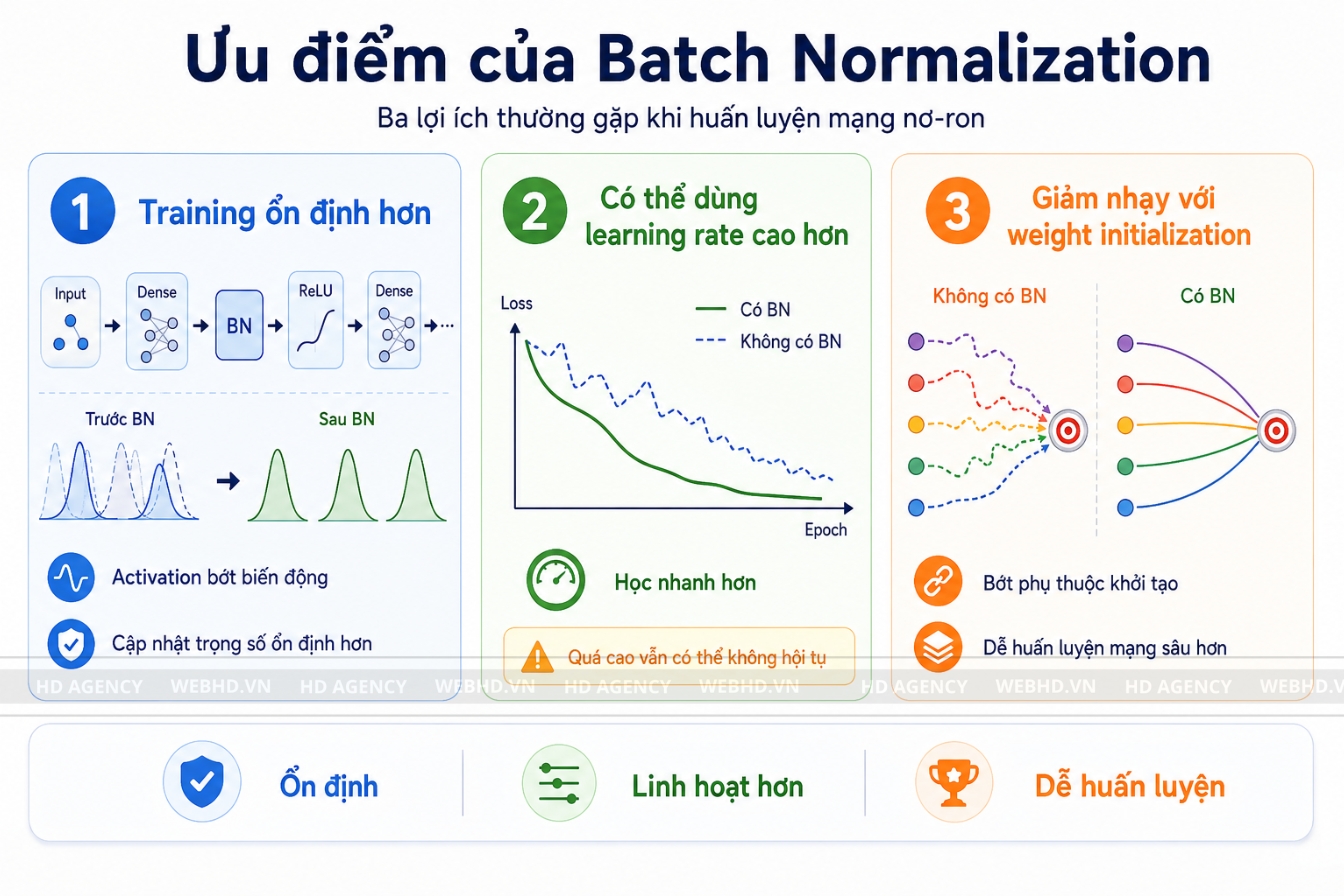
Giúp quá trình training ổn định hơn
BatchNorm giúp hạn chế việc activation thay đổi quá mạnh giữa các lớp.
Nhờ vậy, quá trình cập nhật trọng số thường ổn định hơn, đặc biệt ở những mạng có nhiều lớp.
Có thể sử dụng learning rate cao hơn
Trong một số mô hình, BatchNorm cho phép sử dụng learning rate cao hơn mà training vẫn ổn định.
Learning rate cao hơn có thể giúp mô hình học nhanh hơn, nhưng nếu đặt quá cao thì mô hình cũng có thể không hội tụ.
Hội tụ, hay convergence, nghĩa là trạng thái mà lỗi của mô hình dần ổn định và không còn thay đổi mạnh.
Giảm độ nhạy với weight initialization
Weight initialization là cách đặt giá trị ban đầu cho các trọng số trong mạng nơ-ron.
Nếu khởi tạo không phù hợp, mạng sâu có thể khó học.
BatchNorm thường giúp mô hình bớt nhạy cảm hơn với vấn đề này, dù việc chọn phương pháp khởi tạo trọng số phù hợp vẫn cần thiết.
Hạn chế của Batch Normalization
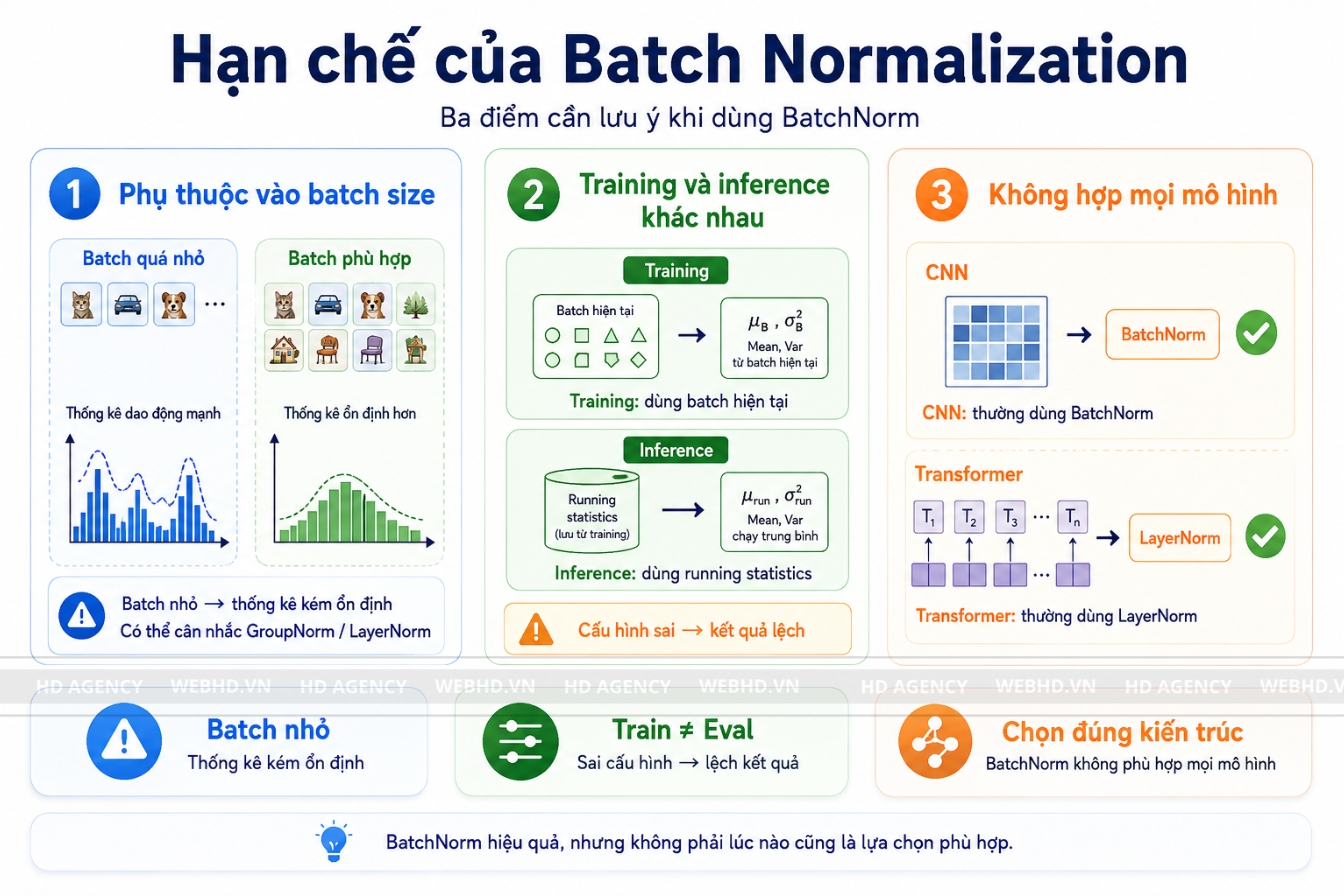
Phụ thuộc vào batch size
Đây là hạn chế dễ nhận thấy.
Vì BatchNorm tính thống kê từ batch nên khi batch quá nhỏ, mean và variance có thể không ổn định.
Đây là lý do một số bài toán có batch size nhỏ lựa chọn Group Normalization hoặc Layer Normalization.
Training và inference hoạt động khác nhau
BatchNorm sử dụng cách tính khác nhau giữa lúc mô hình học và lúc mô hình dự đoán.
Nếu cấu hình không đúng, kết quả inference có thể không giống mong đợi.
Không phù hợp với mọi loại mô hình
BatchNorm được sử dụng nhiều trong CNN.
CNN, viết đầy đủ là Convolutional Neural Network, là loại mạng nơ-ron thường được sử dụng cho dữ liệu hình ảnh.
Trong khi đó, các kiến trúc Transformer thường sử dụng Layer Normalization.
Transformer là kiến trúc đang được dùng rộng rãi trong các mô hình ngôn ngữ và nhiều hệ thống AI xử lý văn bản, hình ảnh hoặc âm thanh.
Batch Normalization và Layer Normalization khác nhau thế nào?
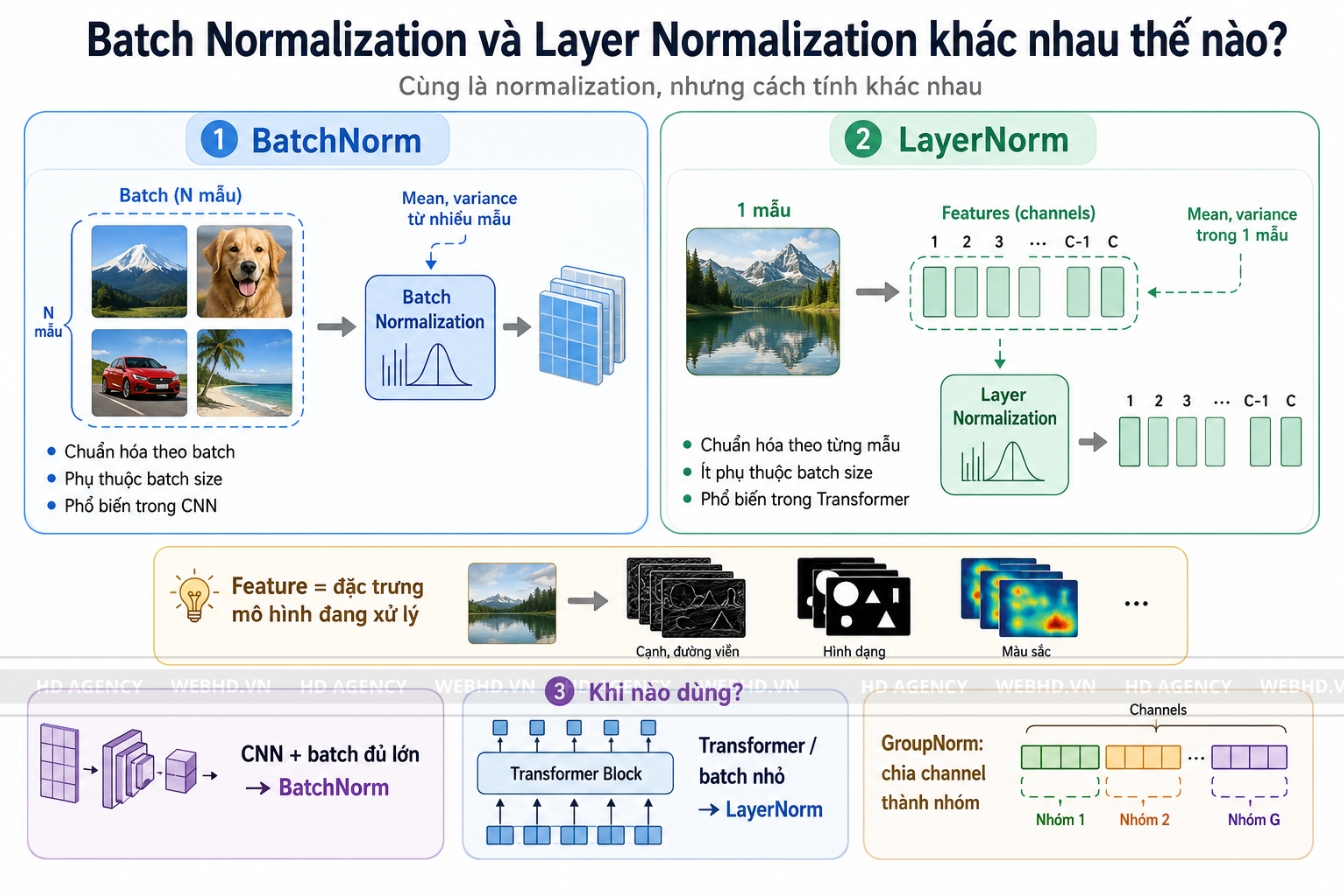
Batch Normalization và Layer Normalization đều là kỹ thuật normalization nhưng cách tính khác nhau.
BatchNorm dựa vào các mẫu nằm trong cùng một batch.
LayerNorm lại chuẩn hóa các feature của từng mẫu riêng biệt. Layer Normalization thường được dùng trong Transformer và các mô hình xử lý dữ liệu theo chuỗi. Điều này cũng dễ thấy ở autoregressive models, nơi mô hình dự đoán dữ liệu tiếp theo dựa trên những thông tin đã xuất hiện trước đó.
Feature có thể hiểu là đặc trưng mà mô hình đang xử lý.
Ví dụ với một ảnh, feature có thể liên quan đến cạnh, hình dạng, màu sắc hoặc các mẫu phức tạp hơn mà mạng tự học.
Điểm đáng chú ý là LayerNorm không phụ thuộc vào batch size theo cách BatchNorm phụ thuộc.
Đây là một trong những lý do Layer Normalization thường xuất hiện trong Transformer.
Với CNN và batch đủ lớn, BatchNorm vẫn là lựa chọn phổ biến.
Với Transformer hoặc trường hợp batch quá nhỏ, LayerNorm hoặc GroupNorm thường được cân nhắc nhiều hơn.
Group Normalization là kỹ thuật chia các channel thành từng nhóm rồi chuẩn hóa trong từng nhóm, thay vì tính thống kê dựa trên toàn bộ batch.
Khi nào nên sử dụng Batch Normalization?
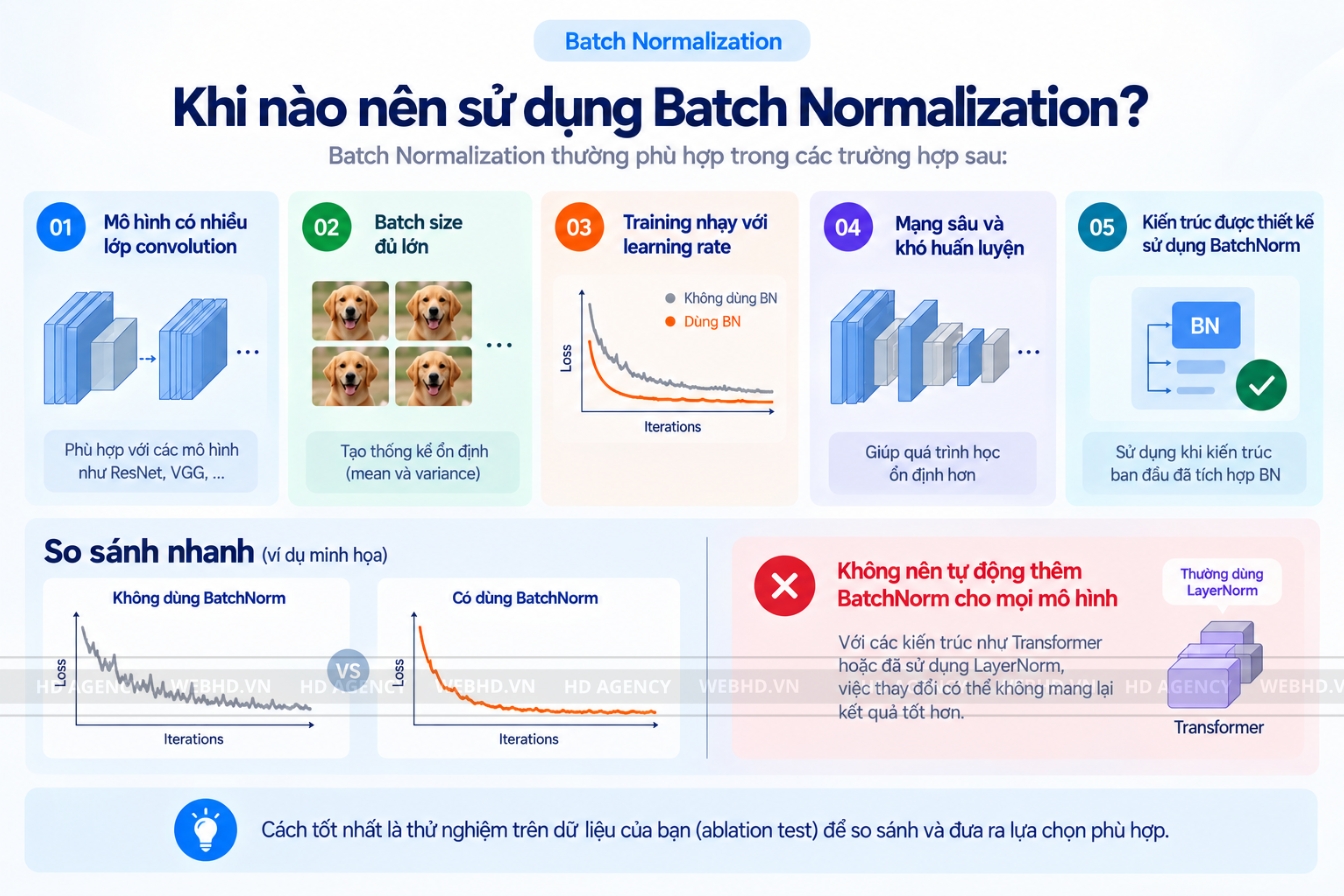
Batch Normalization có thể phù hợp khi:
- Mô hình sử dụng nhiều lớp convolution
- Batch size đủ để tạo thống kê tương đối ổn định
- Training đang nhạy với learning rate
- Mạng có nhiều lớp và khó huấn luyện
- Kiến trúc ban đầu đã được thiết kế sử dụng BatchNorm
Không nên tự động thêm BatchNorm vào mọi mô hình.
Với những kiến trúc đã sử dụng LayerNorm hoặc các kỹ thuật normalization khác, việc thay đổi có thể không mang lại kết quả tốt hơn.
Cách phù hợp hơn là thử nghiệm trực tiếp trên dữ liệu.
Trong Machine Learning, việc so sánh các phiên bản của mô hình khi thay đổi một thành phần thường được gọi là ablation test.
Ví dụ có thể huấn luyện:
Phiên bản A: có BatchNorm
Phiên bản B: không có BatchNorm
Sau đó so sánh:
- Training loss
- Validation loss
- Tốc độ hội tụ
- Độ chính xác hoặc metric mục tiêu
Trong đó, loss là giá trị đo mức sai lệch của mô hình.
Validation loss là mức lỗi được tính trên tập dữ liệu không dùng trực tiếp để cập nhật trọng số, giúp kiểm tra khả năng hoạt động của mô hình trên dữ liệu chưa học.
Metric là chỉ số được dùng để đánh giá kết quả, chẳng hạn accuracy, precision hoặc recall.
Một số câu hỏi thường gặp về Batch Normalization
Batch size càng lớn thì BatchNorm càng tốt?
Không.
Batch lớn có thể giúp mean và variance ổn định hơn, nhưng đồng thời tiêu tốn nhiều RAM hoặc VRAM hơn.
VRAM là bộ nhớ nằm trên GPU và thường là tài nguyên giới hạn khi huấn luyện Deep Learning.
Việc chọn batch size cần dựa trên cả phần cứng và kết quả huấn luyện.
Batch Normalization có hoạt động khi inference không?
Có.
BatchNorm vẫn là một phần của mô hình khi inference. Điểm khác là nó thông thường sử dụng running mean và running variance đã học được thay vì tính lại thống kê từ batch hiện tại.
BatchNorm có thay thế việc chuẩn hóa dữ liệu đầu vào không?
Không.
Đây là hai bước khác nhau.
Chuẩn hóa input xử lý dữ liệu trước khi đưa vào mạng.
BatchNorm xử lý activation được tạo ra bên trong mạng.
Một mô hình hoàn toàn có thể sử dụng cả hai.
BatchNorm có phải lúc nào cũng giúp tăng accuracy?
Không.
Accuracy là tỷ lệ dự đoán đúng của mô hình.
BatchNorm có thể giúp quá trình training thuận lợi hơn nhưng không đảm bảo accuracy cuối cùng luôn tăng.
Kết quả còn phụ thuộc dữ liệu, kiến trúc, optimizer, learning rate và nhiều hyperparameter khác.
Optimizer là thuật toán quyết định cách cập nhật trọng số, chẳng hạn SGD hoặc Adam.
Hyperparameter là những giá trị do người huấn luyện lựa chọn trước hoặc trong quá trình thử nghiệm, ví dụ learning rate, batch size hoặc số epoch.
Epoch là một lượt mô hình đi qua toàn bộ tập dữ liệu huấn luyện.
Batch Normalization là kỹ thuật chuẩn hóa các activation bên trong mạng nơ-ron dựa trên thống kê của mini-batch. Kỹ thuật này tính mean và variance, chuẩn hóa giá trị rồi sử dụng gamma và beta để mô hình tiếp tục tự điều chỉnh cách biểu diễn dữ liệu.
Cần phân biệt chuẩn hóa dữ liệu đầu vào với các kỹ thuật normalization nằm bên trong mạng. Khi tìm hiểu batch size là gì, cũng cần lưu ý rằng đây là số mẫu được xử lý trước mỗi lần cập nhật trọng số và có ảnh hưởng trực tiếp đến cách BatchNorm tính thống kê.
Batch Normalization thường phù hợp với các mạng CNN có batch size đủ lớn. Với Transformer hoặc những trường hợp phải dùng batch rất nhỏ, Layer Normalization hay Group Normalization có thể phù hợp hơn.
Điều quan trọng không phải là thêm BatchNorm vào mọi mô hình, mà là hiểu nó đang giải quyết vấn đề gì, cách nó hoạt động khi training và inference, sau đó đánh giá hiệu quả dựa trên dữ liệu thực tế.