Từ dự báo doanh thu theo tháng đến việc LLM sinh từng token, autoregressive models đều dựa trên cùng một nguyên tắc: phần sau phụ thuộc vào phần đã xuất hiện trước đó. Tuy nhiên, cách áp dụng trong time series và generative AI có nhiều điểm khác nhau. HD Agency sẽ phân tích từng phần để bạn hiểu rõ cơ chế, ưu điểm, hạn chế và trường hợp nên sử dụng autoregressive model.
Autoregressive models là gì?
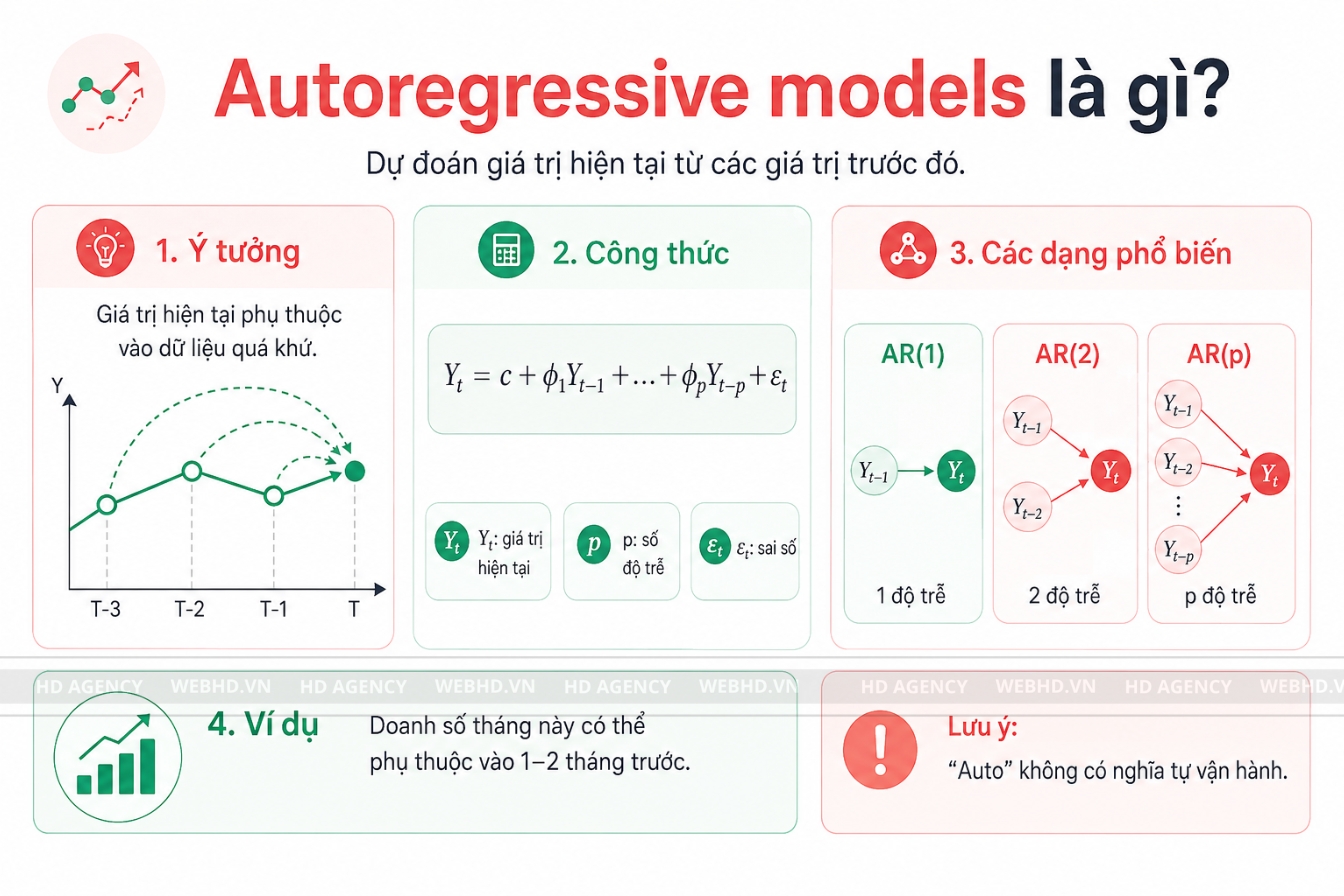
Autoregressive models, thường viết tắt là AR, là các mô hình trong đó giá trị hiện tại hoặc kế tiếp được ước lượng từ một hay nhiều giá trị trước đó của chính biến đang xét. Với chuỗi thời gian, AR(1) dùng một giá trị trễ, AR(2) dùng hai giá trị trễ, còn AR(p) sử dụng p độ trễ. IBM và Penn State đều mô tả autoregression theo nguyên tắc lấy các quan sát trước của cùng một chuỗi làm biến dự báo cho quan sát hiện tại.
Doanh nghiệp xây dựng nội dung về AI, dữ liệu hoặc phần mềm, hiểu đúng khái niệm này giúp tách rõ ý định tìm kiếm giữa thống kê chuỗi thời gian và generative AI. HD Agency có thể triển khai dịch vụ SEO theo cụm chủ đề, tổ chức bài viết hỗ trợ lẫn nhau và kiểm soát cách dùng thuật ngữ kỹ thuật để nội dung dễ đọc hơn mà không phải lặp từ khóa dày.
Từ “auto” trong autoregression không có nghĩa mô hình tự vận hành. Nó chỉ việc một biến được hồi quy dựa trên các giá trị trước của chính nó. Nếu doanh số tháng này có quan hệ với doanh số một hoặc hai tháng trước, các giá trị đó có thể được dùng làm biến dự báo.
Autoregressive và autoregression khác nhau thế nào?
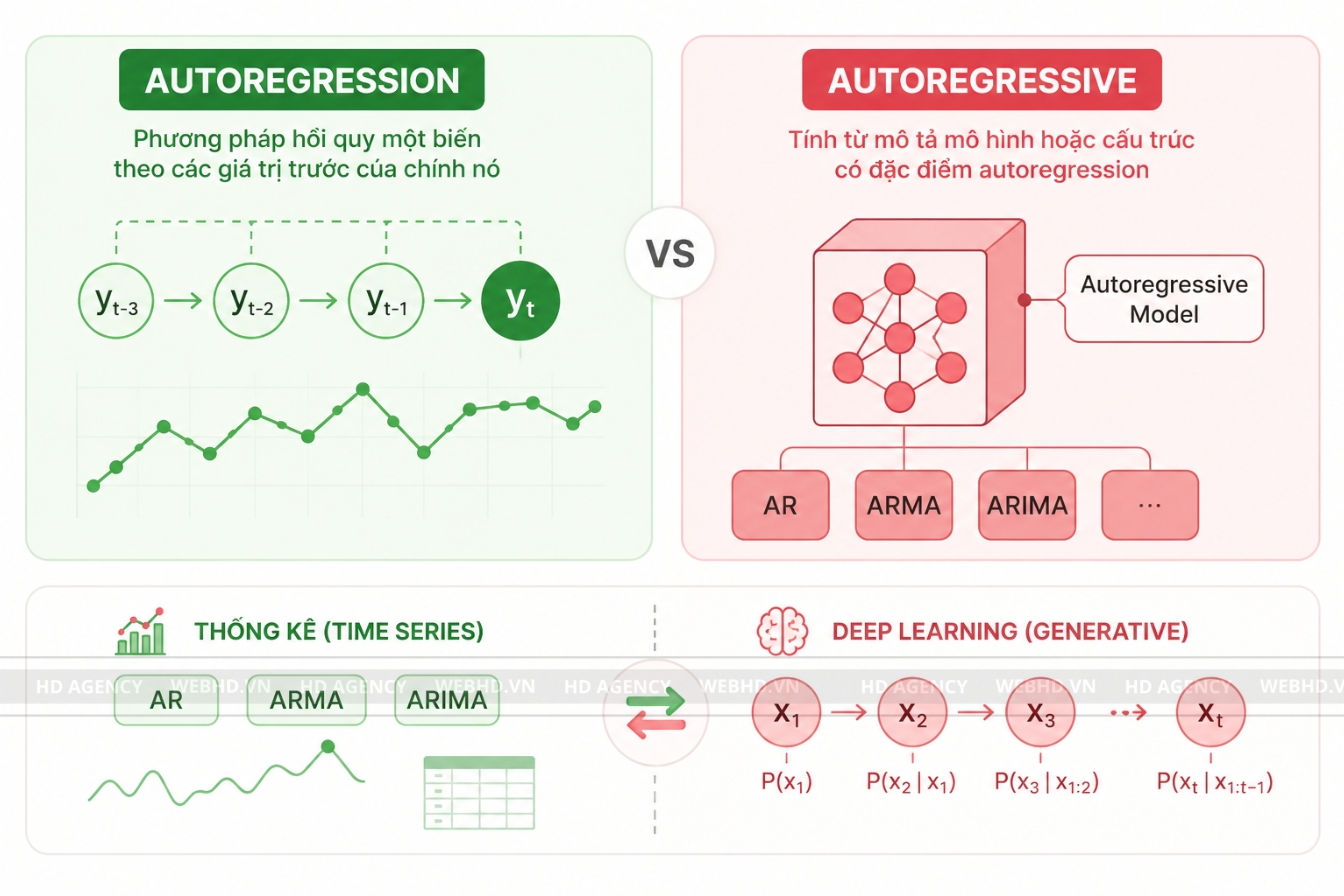
Autoregression là phương pháp hồi quy một biến theo các giá trị trước của chính nó. Autoregressive là tính từ mô tả mô hình hoặc cấu trúc có đặc điểm đó.
Vì vậy, “autoregressive model” là mô hình áp dụng cơ chế autoregression, còn “autoregressive models” dùng khi nói về cả nhóm. Trong thống kê, thuật ngữ này thường đi cùng AR, ARMA hoặc ARIMA; trong deep learning, nó còn chỉ cách phân rã xác suất của một chuỗi thành các xác suất có điều kiện nối tiếp nhau.
Autoregressive model hoạt động như thế nào?
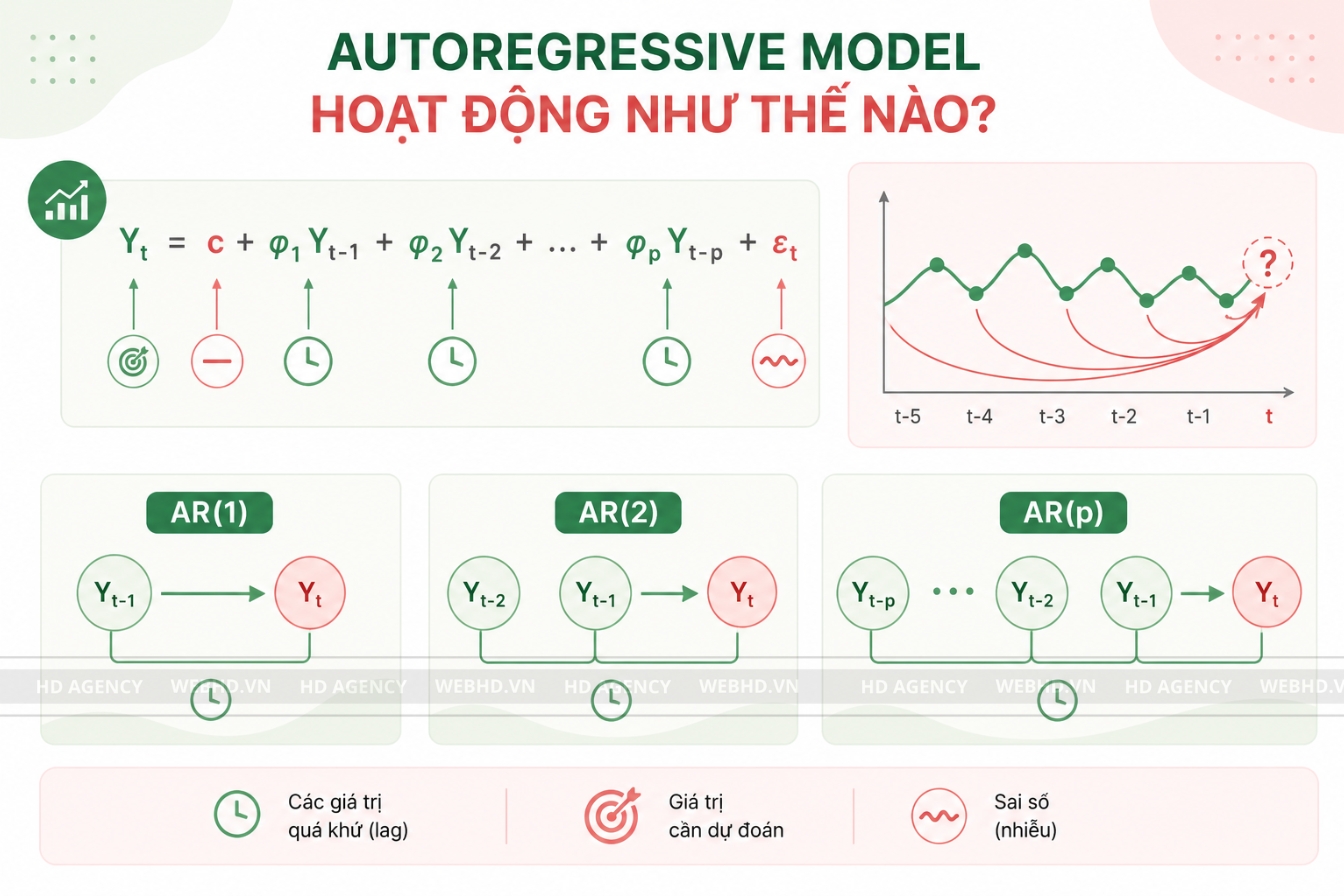
Với chuỗi thời gian một biến, dạng tổng quát của AR(p) có thể viết:
Yt = c + φ1Yt-1 + φ2Yt-2 + … + φpYt-p + εt
Trong đó Yt là giá trị cần ước lượng; c là hằng số; φ là các hệ số thể hiện mức ảnh hưởng của từng độ trễ; p là số lag; εt là sai số. NIST mô tả AR là hồi quy giá trị hiện tại lên một hoặc nhiều giá trị trước đó của cùng chuỗi.
Nếu doanh thu tháng 9 được dự đoán từ doanh thu tháng 8, đó có thể là AR(1). Nếu mô hình dùng thêm tháng 7 và tháng 6, số bậc tăng tương ứng. Tuy nhiên, tăng lag không đồng nghĩa dự báo sẽ tốt hơn. AWS lưu ý lag có hệ số gần 0 có thể đóng góp rất ít, trong khi số lag quá lớn làm mô hình phức tạp hơn.
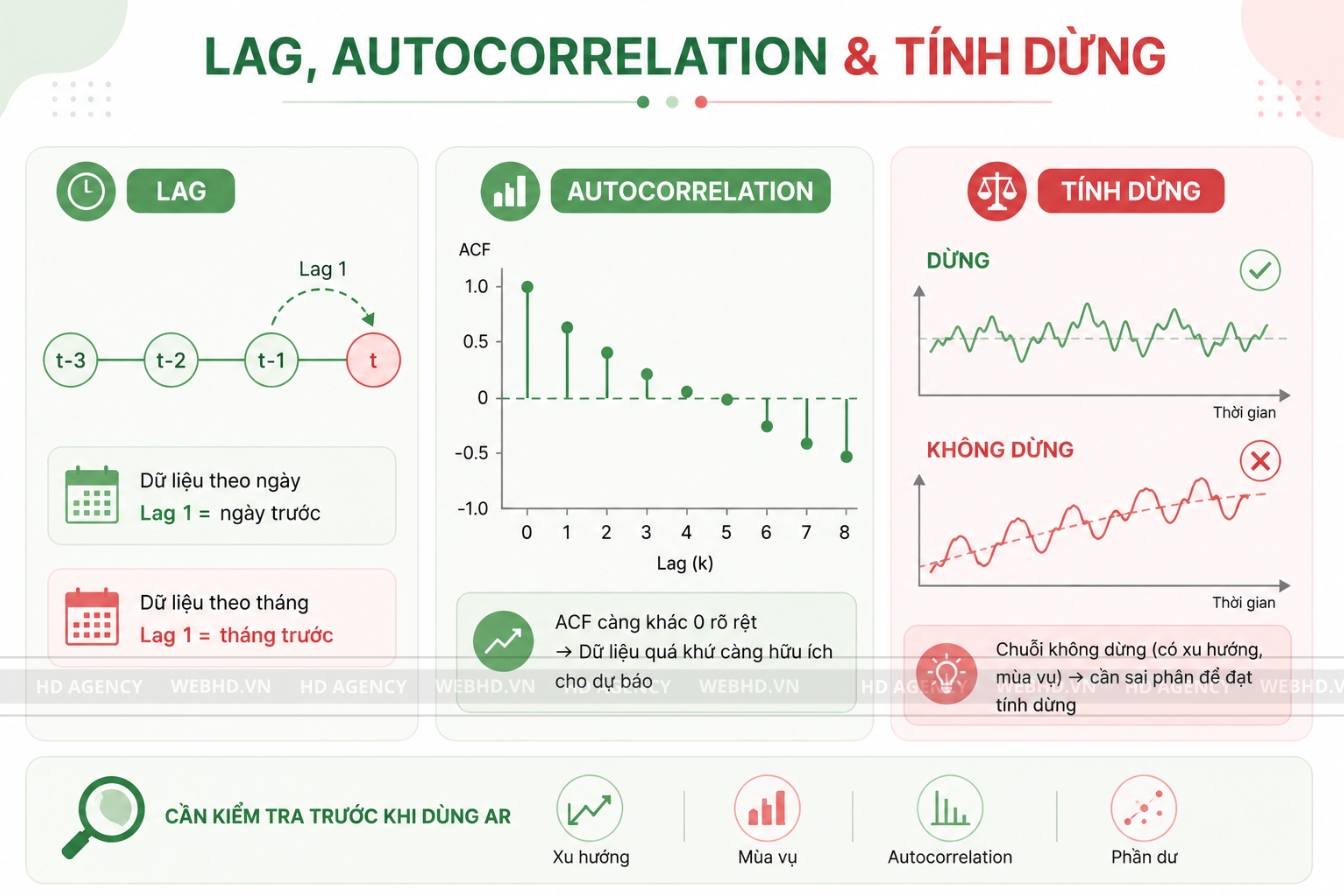
Lag, autocorrelation và tính dừng
Lag là khoảng lùi theo thời gian. Với dữ liệu theo ngày, lag 1 thường là ngày trước; với dữ liệu theo tháng, lag 1 là tháng trước. Autocorrelation đo mức liên hệ giữa chuỗi và phiên bản trễ của chính nó. Khi mối liên hệ đủ rõ, dữ liệu quá khứ có thể cung cấp tín hiệu cho dự báo.
Nhiều mô hình AR cổ điển giả định chuỗi có tính dừng. CFA Institute lưu ý việc ước lượng mô hình autoregressive bằng hồi quy yêu cầu chuỗi dừng theo hiệp phương sai; nếu chuỗi có unit root, sai phân có thể giúp chuyển dữ liệu sang dạng phù hợp hơn. Vì vậy, cần kiểm tra xu hướng, mùa vụ, autocorrelation và phần dư trước khi sử dụng AR.
Autoregressive trong AI tạo sinh và mô hình ngôn ngữ
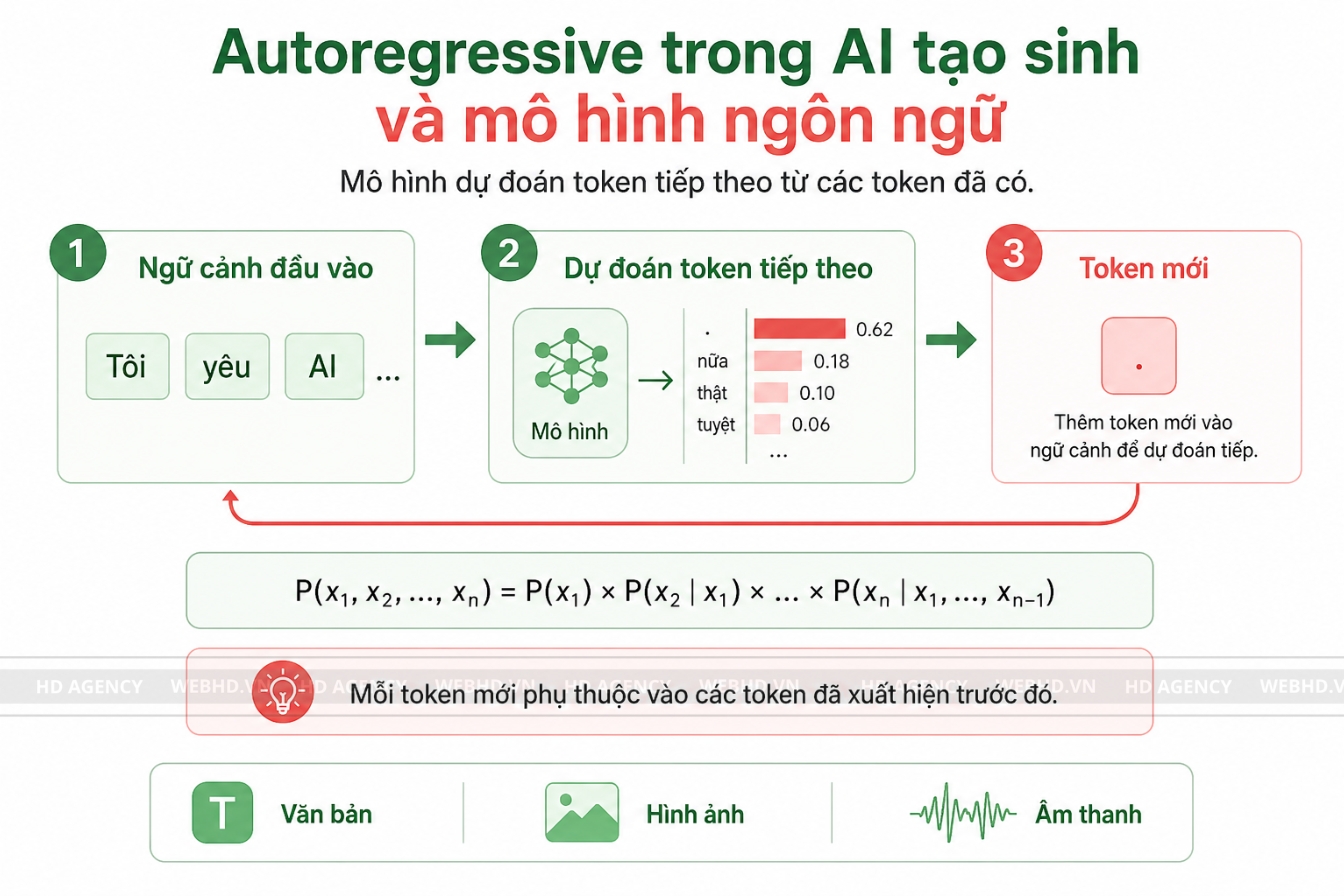
Trong generative AI, ý tưởng autoregressive được mở rộng từ chuỗi số sang token, pixel hoặc mẫu âm thanh. Với văn bản, mô hình ước lượng xác suất của token tiếp theo dựa trên các token đã có. Sau khi token mới được chọn, nó trở thành một phần ngữ cảnh cho bước kế tiếp.
TensorFlow mô tả Transformer dùng cho sinh văn bản theo kiểu autoregressive: văn bản được tạo từng token, đầu ra trước được đưa lại vào đầu vào và causal attention ngăn vị trí hiện tại nhìn thấy các token phía sau. Hugging Face cũng mô tả autoregressive language models là các mô hình học nhiệm vụ đoán token tiếp theo từ những token đã đọc trước đó.
Ở dạng xác suất, một chuỗi x1, x2, …, xn có thể được phân rã:
P(x1, x2, …, xn) = P(x1) × P(x2|x1) × … × P(xn|x1, …, xn-1)
Mỗi phần tử mới phụ thuộc vào phần chuỗi đã xuất hiện. Trong mô hình ngôn ngữ, phần tử là token; với PixelCNN có thể là pixel; với WaveNet, nguyên tắc tương tự được áp dụng cho tín hiệu âm thanh.
Vì sao LLM thường sinh token tuần tự?
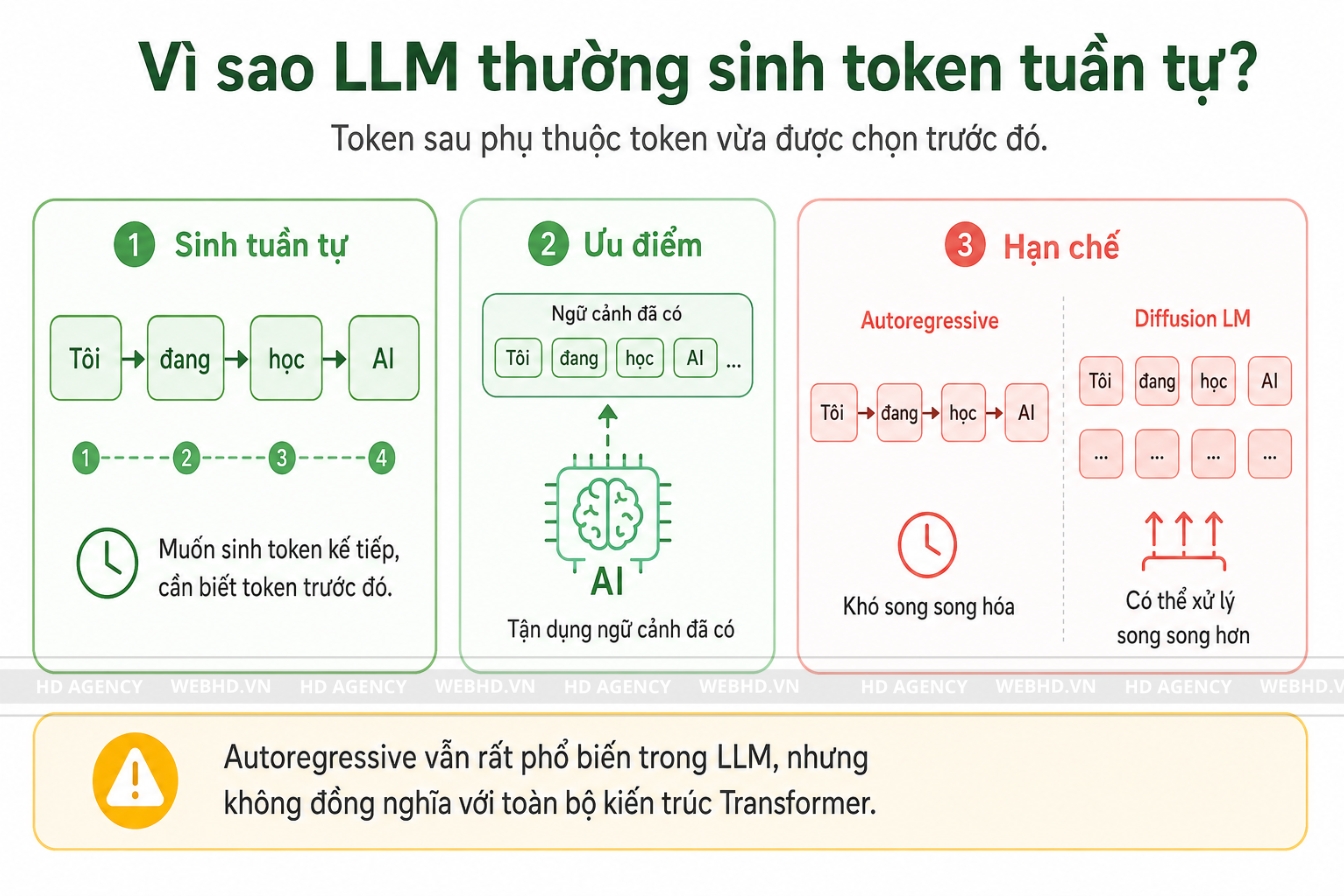
Cơ chế dự đoán token tiếp theo tạo ra chuỗi phụ thuộc: muốn sinh token sau phải biết token vừa được chọn trước đó. Điều này giúp mô hình dùng ngữ cảnh đã có, nhưng khiến giải mã khó song song hoàn toàn.
Nghiên cứu của Apple công bố tháng 8/2026 mô tả autoregressive language models là cách tiếp cận phổ biến ở LLM nhưng chỉ ra hạn chế hiệu năng do sự phụ thuộc tuần tự của next-token prediction. Nghiên cứu này so sánh chúng với diffusion language models, nơi nhiều token có thể được xử lý song song hơn.
Điều đó không có nghĩa autoregressive sắp bị thay thế. Hai hướng có cơ chế và chi phí khác nhau. Chữ autoregressive trong LLM nói đến quy tắc tạo chuỗi theo điều kiện của phần đã sinh, không đồng nghĩa với toàn bộ kiến trúc Transformer.
Các dạng autoregressive models thường gặp
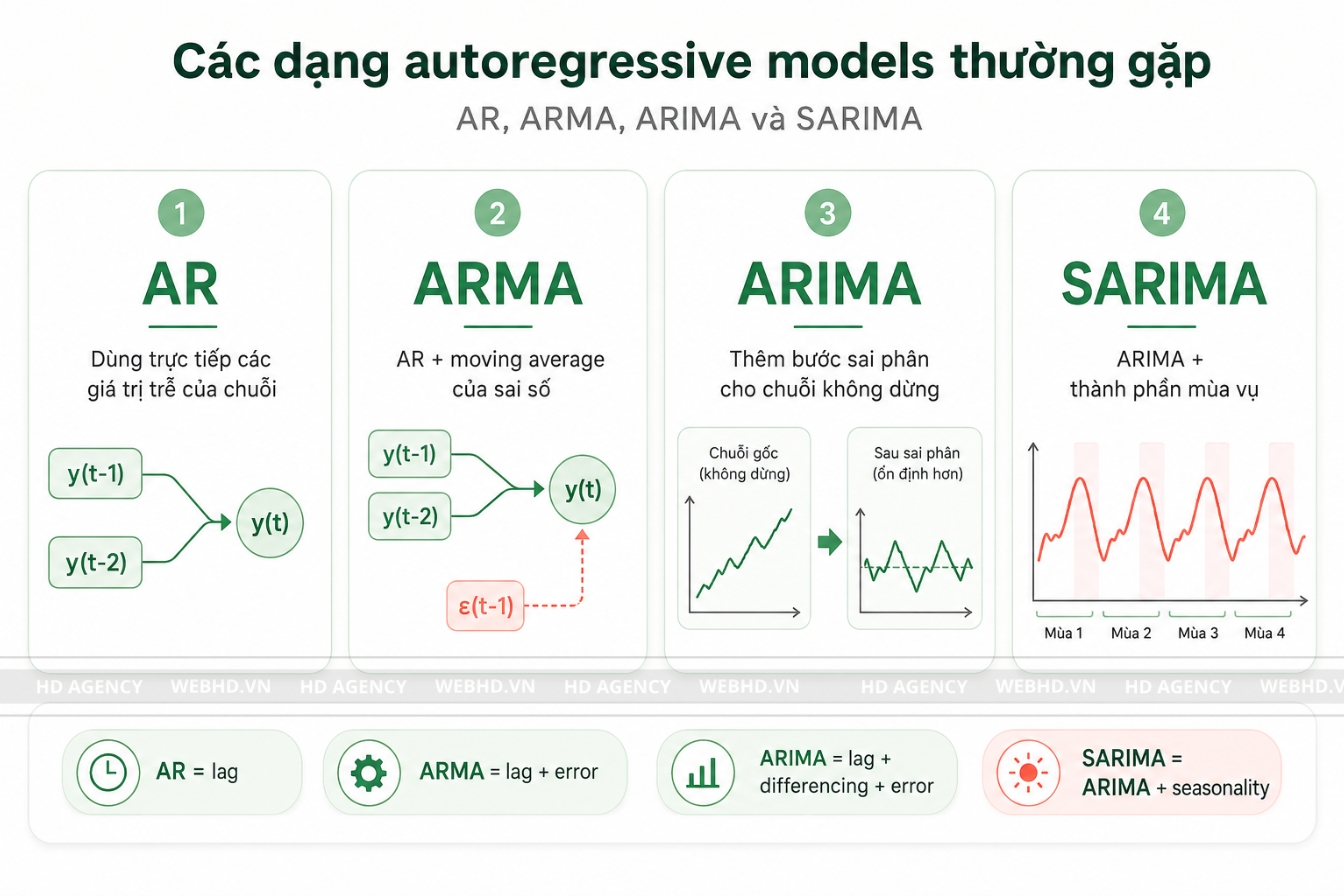
AR, ARMA và ARIMA
AR dùng trực tiếp các giá trị trễ của chuỗi. ARMA kết hợp thành phần autoregressive với moving average của sai số. ARIMA bổ sung bước sai phân để xử lý một số chuỗi không dừng. Nếu dữ liệu có mùa vụ, SARIMA thêm các thành phần theo chu kỳ.
Ưu điểm của autoregressive models
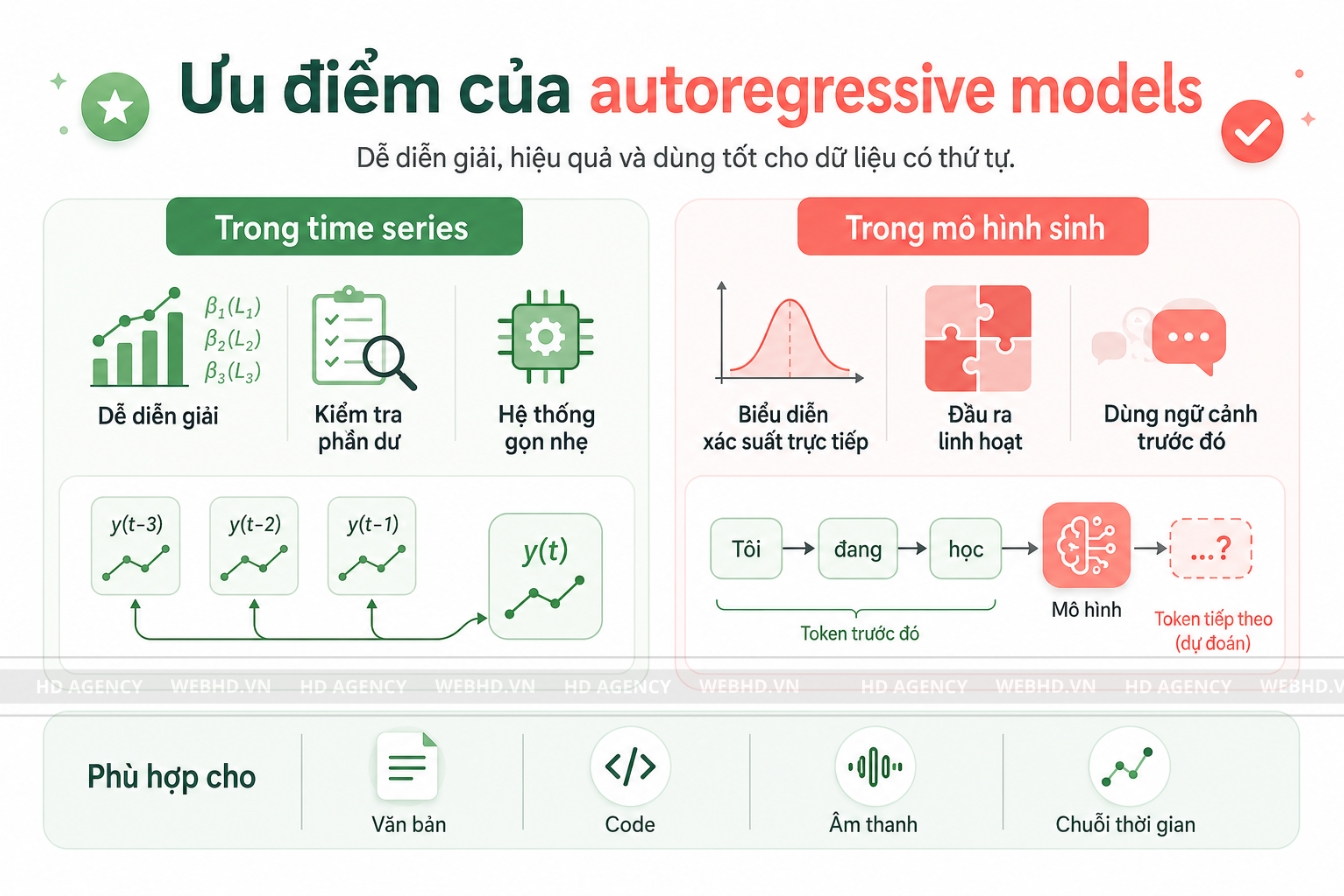
Time series, AR có cách diễn giải tương đối rõ. Người phân tích có thể xem hệ số lag, kiểm tra phần dư và đánh giá mức phụ thuộc của chuỗi vào lịch sử. Với dữ liệu phù hợp, mô hình có thể hoạt động hiệu quả mà không cần hệ thống quá nặng.
Mô hình sinh, autoregressive cho phép biểu diễn xác suất tuần tự trực tiếp, tạo đầu ra có độ dài linh hoạt và dùng lịch sử đã sinh làm ngữ cảnh cho bước kế tiếp. Cơ chế này phù hợp với văn bản, code, âm thanh và nhiều loại dữ liệu có thứ tự.
Hạn chế của autoregressive model
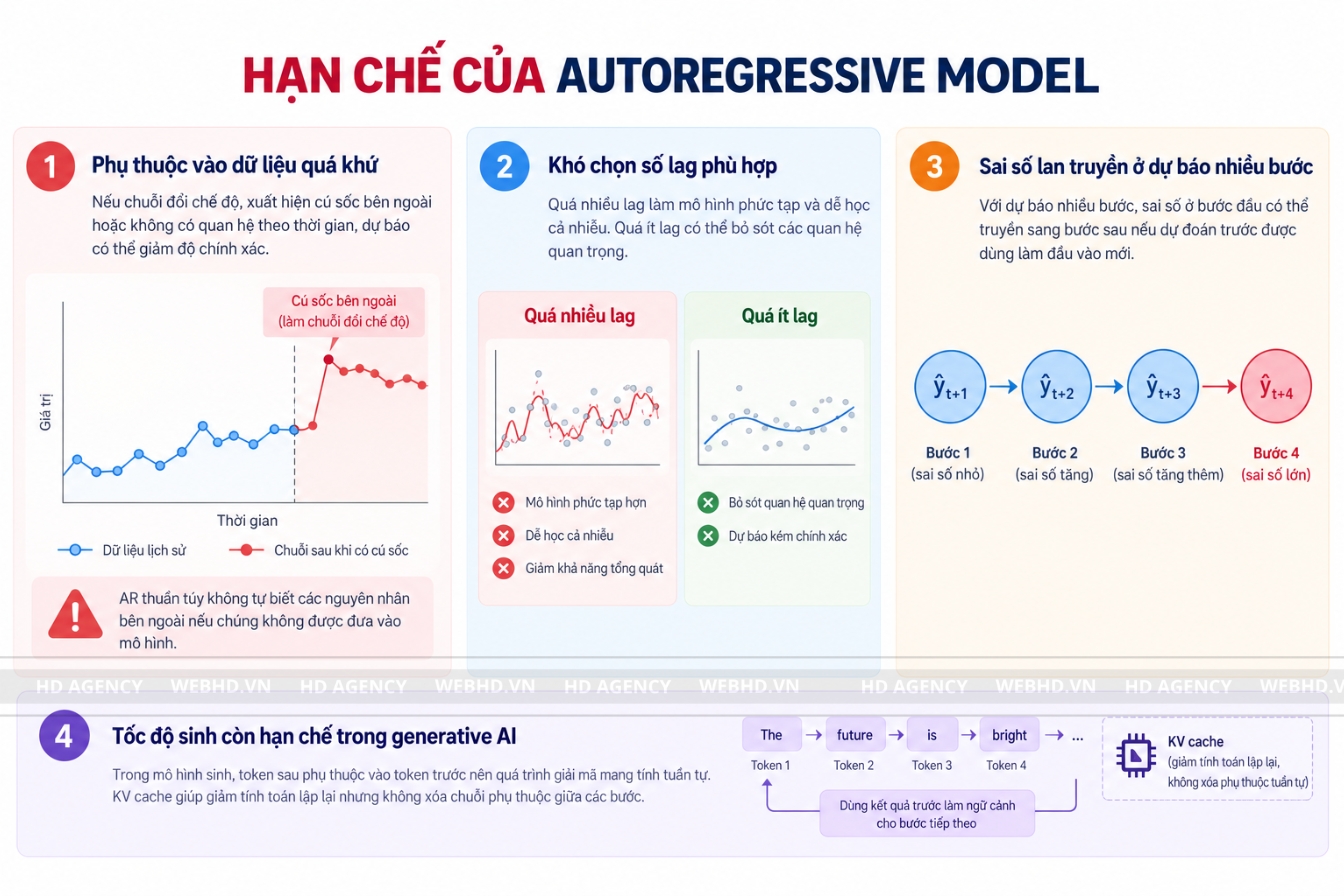
Autoregressive model phụ thuộc mạnh vào chất lượng dữ liệu quá khứ. Nếu chuỗi đổi chế độ, xuất hiện cú sốc bên ngoài hoặc không có quan hệ theo thời gian, dự báo có thể giảm độ chính xác. AR thuần túy cũng không tự biết các nguyên nhân bên ngoài nếu chúng không được đưa vào mô hình.
Chọn quá nhiều lag có thể tăng độ phức tạp và khiến mô hình học cả nhiễu; chọn quá ít lag lại bỏ sót quan hệ quan trọng. Với dự báo nhiều bước, sai số ở bước đầu có thể truyền sang bước sau nếu dự đoán trước được dùng làm đầu vào mới.
Trong generative AI, hạn chế lớn nằm ở tốc độ sinh. Vì token sau phụ thuộc phần trước, quá trình giải mã mang tính tuần tự. KV cache giúp giảm tính toán lặp lại nhưng không xóa chuỗi phụ thuộc giữa các bước.
Khi nào nên dùng autoregressive model?
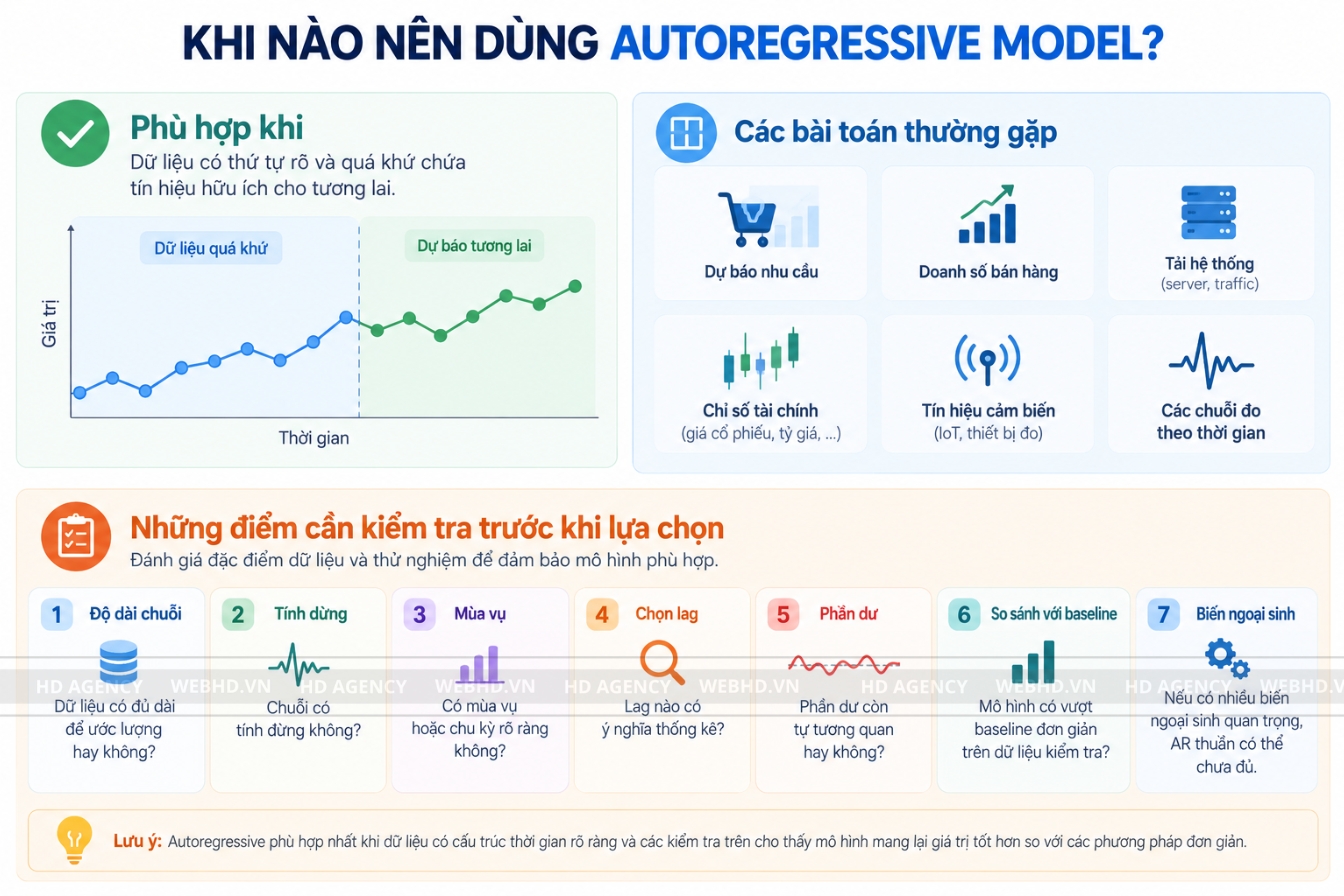
Autoregressive phù hợp khi dữ liệu có thứ tự rõ và quá khứ chứa tín hiệu hữu ích cho tương lai. Các bài toán thường gặp gồm dự báo nhu cầu, doanh số, tải hệ thống, chỉ số tài chính, tín hiệu cảm biến hoặc các chuỗi đo theo thời gian.
Trước khi chọn mô hình, nên kiểm tra chuỗi có đủ dài không, có tính dừng không, mùa vụ ra sao, lag nào có ý nghĩa, phần dư còn tự tương quan hay không và mô hình có vượt baseline đơn giản trên dữ liệu kiểm tra hay không. Nếu dữ liệu có nhiều biến ngoại sinh quan trọng, AR thuần có thể chưa đủ.
Autoregressive models khác gì với mô hình không autoregressive?
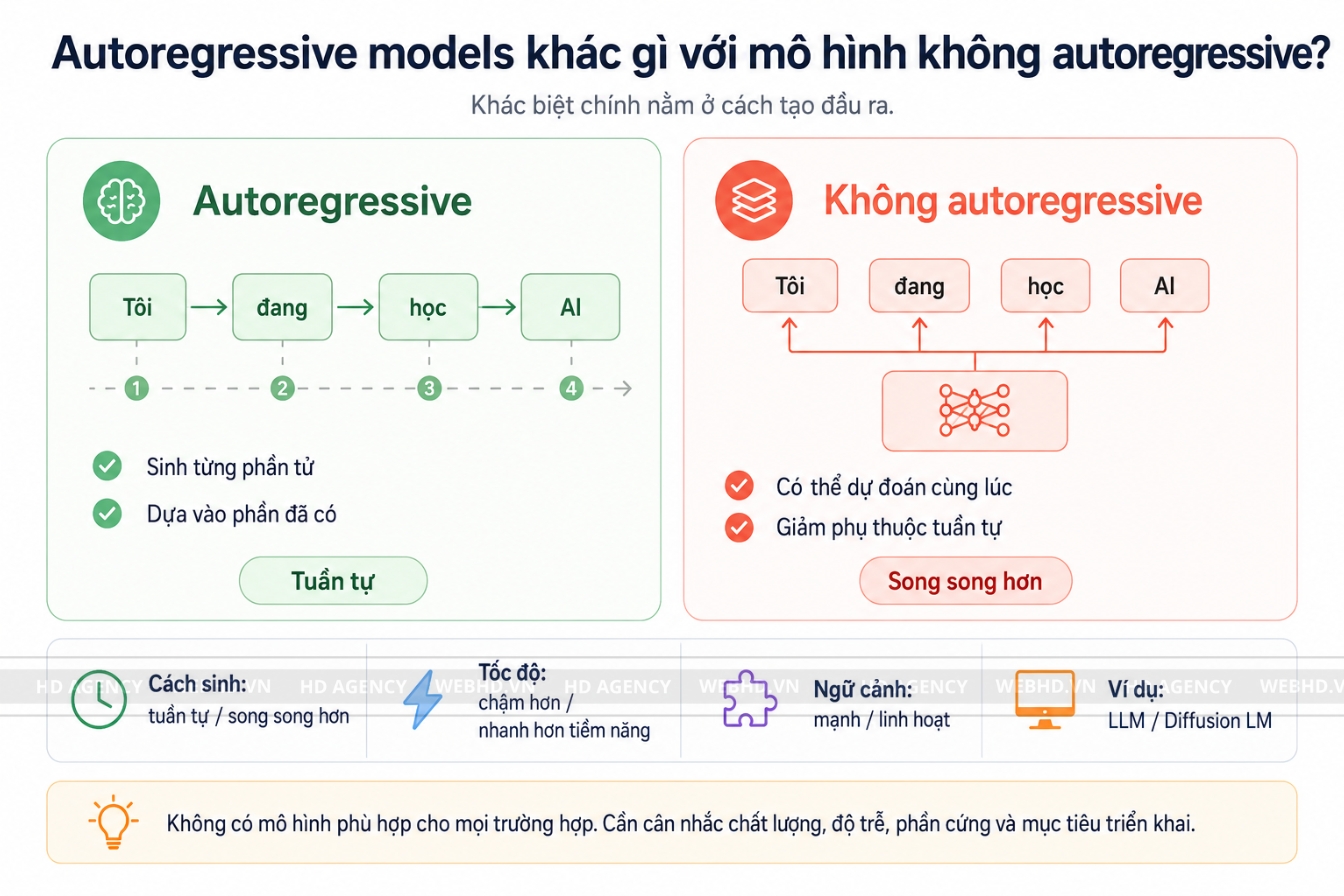
Khác biệt chính nằm ở cách tạo đầu ra. Autoregressive tạo từng phần tử theo điều kiện của phần đã có. Mô hình không autoregressive có thể dự đoán nhiều vị trí cùng lúc hoặc dùng cơ chế tạo mẫu khác để giảm phụ thuộc tuần tự.
Trong NLP, diffusion language models đang được nghiên cứu như một hướng khác cho next-token generation ở một số bài toán. Chúng có thể cập nhật nhiều token qua nhiều vòng thay vì bắt buộc sinh từ trái sang phải từng token. Việc so sánh cần dựa trên chất lượng, độ trễ, phần cứng và mục tiêu triển khai cụ thể.
Câu hỏi thường gặp về Autoregressive Models
Autoregressive Models là gì?
Autoregressive Models là nhóm mô hình dự đoán giá trị tiếp theo dựa trên các giá trị đã xuất hiện trước đó. Mô hình thường được dùng trong chuỗi thời gian, dự báo dữ liệu và AI tạo sinh.
Autoregressive model được sử dụng để làm gì?
Autoregressive model được dùng để dự báo doanh số, nhu cầu, chỉ số tài chính, dữ liệu cảm biến và nhiều loại chuỗi thời gian. Trong AI, mô hình còn được dùng để sinh văn bản, mã nguồn và âm thanh.
Autoregressive khác gì với ARIMA?
Autoregressive chỉ sử dụng các giá trị trễ của chính chuỗi dữ liệu để dự báo. ARIMA kết hợp autoregressive, sai phân và moving average nên phù hợp với nhiều chuỗi dữ liệu phức tạp hơn.
Lag trong Autoregressive Models là gì?
Lag là giá trị dữ liệu ở các thời điểm trước được dùng làm đầu vào cho mô hình. Ví dụ, lag 1 là kỳ ngay trước đó, còn lag 2 là hai kỳ trước.
Vì sao autoregressive model cần dữ liệu có tính dừng?
Dữ liệu có tính dừng giúp mối quan hệ giữa các giá trị trong chuỗi ổn định hơn theo thời gian. Nếu chuỗi có xu hướng hoặc biến động mạnh, kết quả dự báo có thể kém chính xác.
Autoregressive Models có được sử dụng trong LLM không?
Có. Nhiều LLM sử dụng cơ chế autoregressive để dự đoán token tiếp theo dựa trên các token đã xuất hiện. Token vừa tạo sẽ tiếp tục được dùng làm ngữ cảnh cho bước tiếp theo.
Hạn chế của Autoregressive Models là gì?
Mô hình phụ thuộc nhiều vào dữ liệu lịch sử và có thể hoạt động kém khi chuỗi thay đổi cấu trúc hoặc chịu tác động mạnh từ yếu tố bên ngoài. Với AI tạo sinh, việc sinh tuần tự cũng có thể làm tăng thời gian xử lý.
Khi nào nên sử dụng autoregressive model?
Nên sử dụng autoregressive model khi dữ liệu có thứ tự rõ ràng và các giá trị trong quá khứ có liên hệ với tương lai. Trước khi áp dụng, cần kiểm tra autocorrelation, tính dừng và độ chính xác trên tập kiểm tra.
Autoregressive models là khái niệm nối thống kê chuỗi thời gian với nhiều hệ thống AI tạo sinh. Ở time series, mô hình dùng các giá trị trễ của chính chuỗi để ước lượng hiện tại hoặc tương lai. Ở mô hình ngôn ngữ, nguyên tắc tương tự thể hiện qua việc dự đoán token kế tiếp từ các token đã xuất hiện.
Trong các bài toán dự báo, autoregressive models thường được dùng cùng nhiều kỹ thuật AI phân tích dữ liệu để nhận diện xu hướng, kiểm tra mối liên hệ giữa các giá trị theo thời gian và hỗ trợ lựa chọn mô hình phù hợp.