Nếu từng học đạo hàm, bạn có thể đã gặp Chain Rule dưới tên gọi quy tắc dây chuyền. Điều thú vị là kiến thức này cũng xuất hiện trong machine learning và backpropagation. HD Agency sẽ giúp bạn hiểu Chain Rule là gì và vì sao nó có vai trò trong cách AI học từ dữ liệu.
Chain Rule là gì?
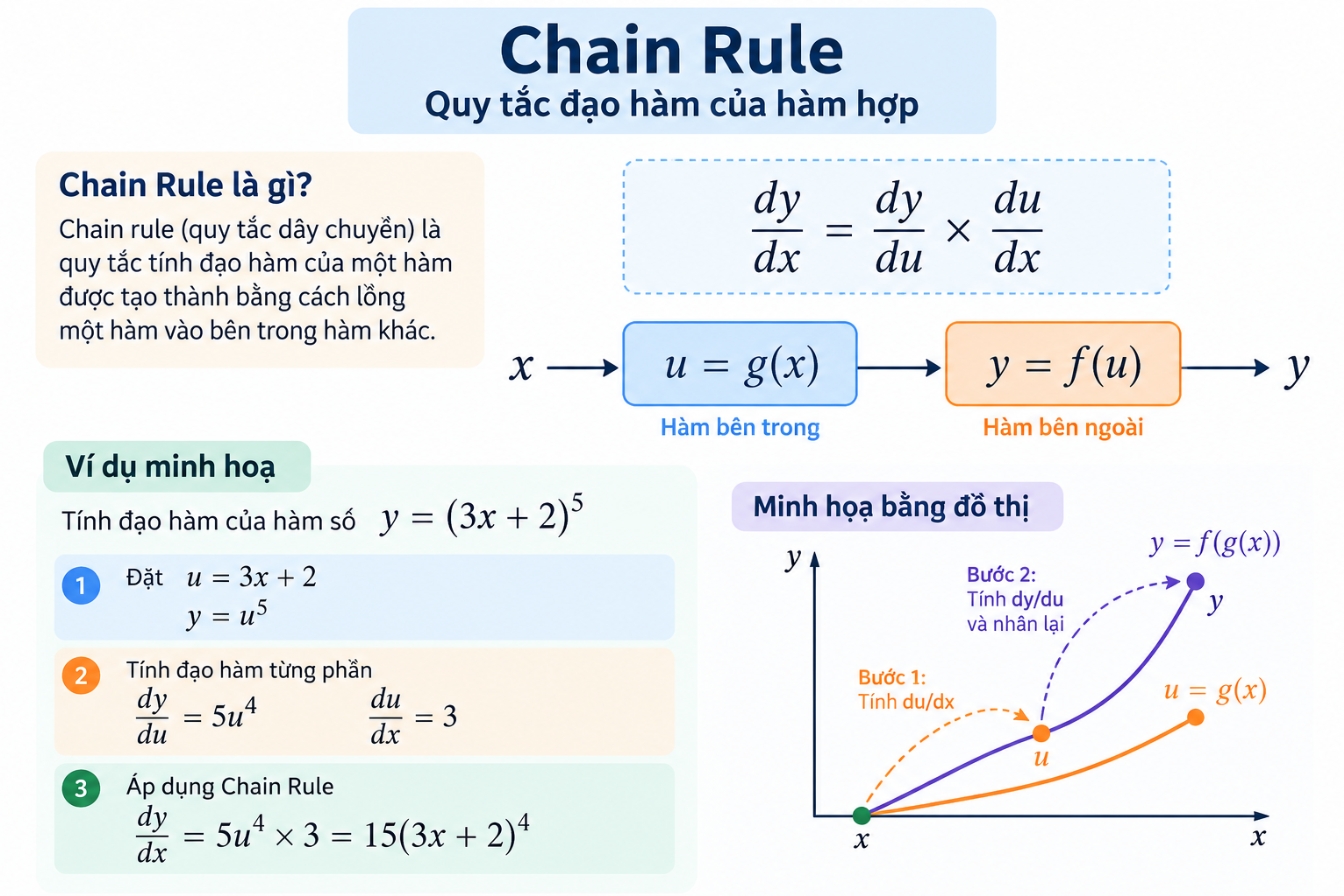
Chain rule, hay quy tắc dây chuyền, là quy tắc tính đạo hàm của một hàm được tạo thành bằng cách lồng một hàm vào bên trong hàm khác. Nếu đầu ra của hàm thứ nhất trở thành đầu vào của hàm thứ hai, sự thay đổi của biến ban đầu sẽ tác động lần lượt qua từng hàm. Chain rule cho phép tính mức độ tác động đó.
Giả sử:
y = f(u)
và:
u = g(x)
Khi đó:
y = f(g(x))
Theo chain rule:
dy/dx = dy/du × du/dx
Hoặc viết dưới dạng khác:
(f(g(x)))’ = f'(g(x)) × g'(x)
Có thể hiểu đơn giản: lấy đạo hàm của hàm bên ngoài, giữ nguyên phần bên trong, sau đó nhân với đạo hàm của hàm bên trong.
OpenStax mô tả chain rule theo cùng nguyên tắc: đạo hàm của hàm hợp bằng đạo hàm của hàm ngoài được đánh giá tại hàm trong, nhân với đạo hàm của hàm trong.
Những khái niệm nền như chain rule cũng hữu ích khi doanh nghiệp xây dựng nội dung chuyên sâu về AI, công nghệ hoặc phần mềm. Với dịch vụ SEO của HD Agency, nội dung kỹ thuật cần được xử lý theo đúng ý định tìm kiếm, giải thích đủ sâu và có cấu trúc rõ ràng thay vì chỉ lặp lại từ khóa. Đây cũng là yếu tố quan trọng khi xây dựng cụm nội dung cho các website thuộc lĩnh vực công nghệ.
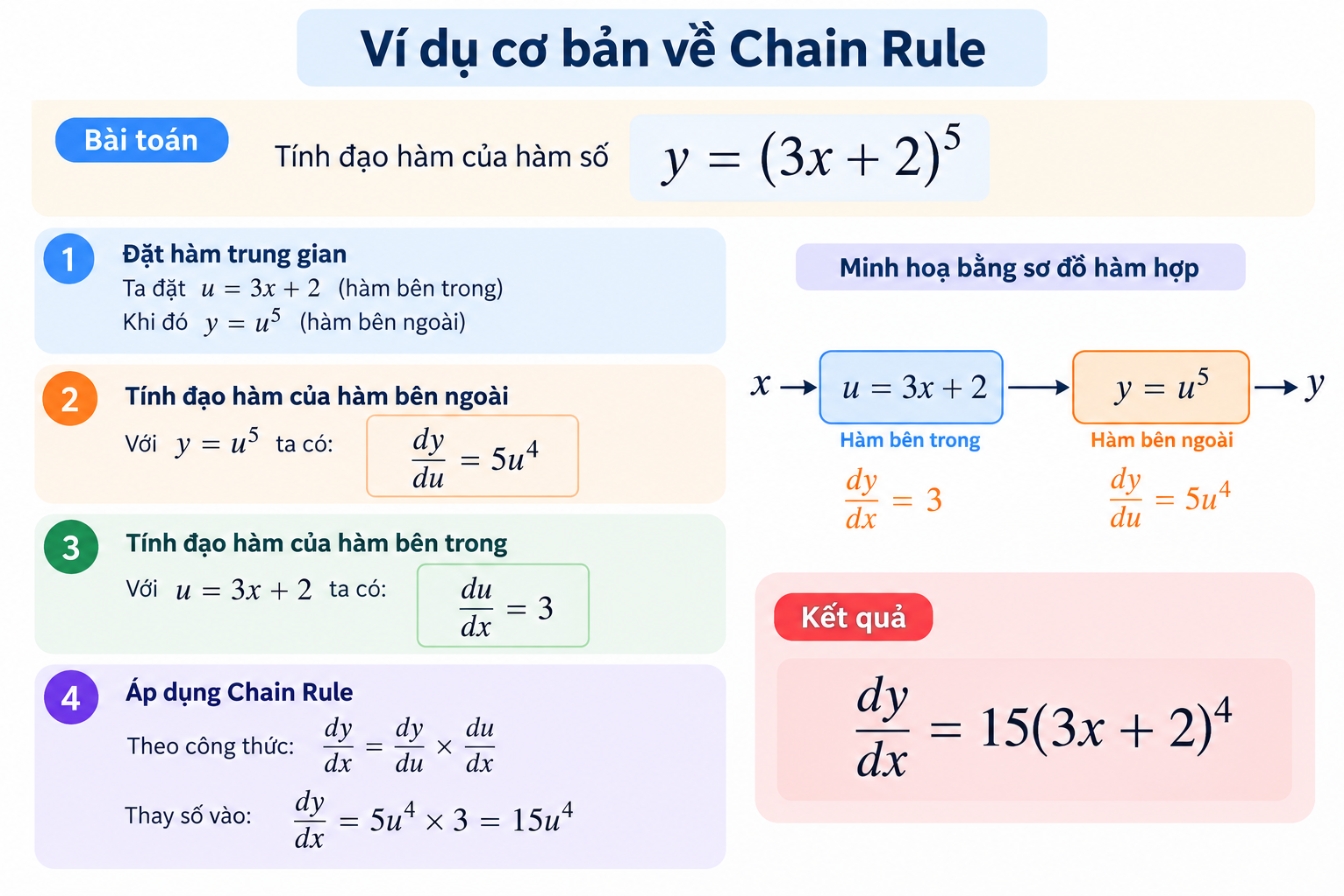
Ví dụ cơ bản về Chain Rule
Xét hàm:
y = (3x + 2)⁵
Ta có thể tách thành:
u = 3x + 2
y = u⁵
Đạo hàm của y theo u:
dy/du = 5u⁴
Đạo hàm của u theo x:
du/dx = 3
Áp dụng chain rule:
dy/dx = 5u⁴ × 3
Thay u = 3x + 2:
y’ = 15(3x + 2)⁴
Điểm dễ bị bỏ sót là hệ số 3. Nếu chỉ lấy đạo hàm của lũy thừa bên ngoài mà quên đạo hàm của 3x + 2, kết quả sẽ sai.
Cách nhận biết bài toán cần dùng Chain Rule
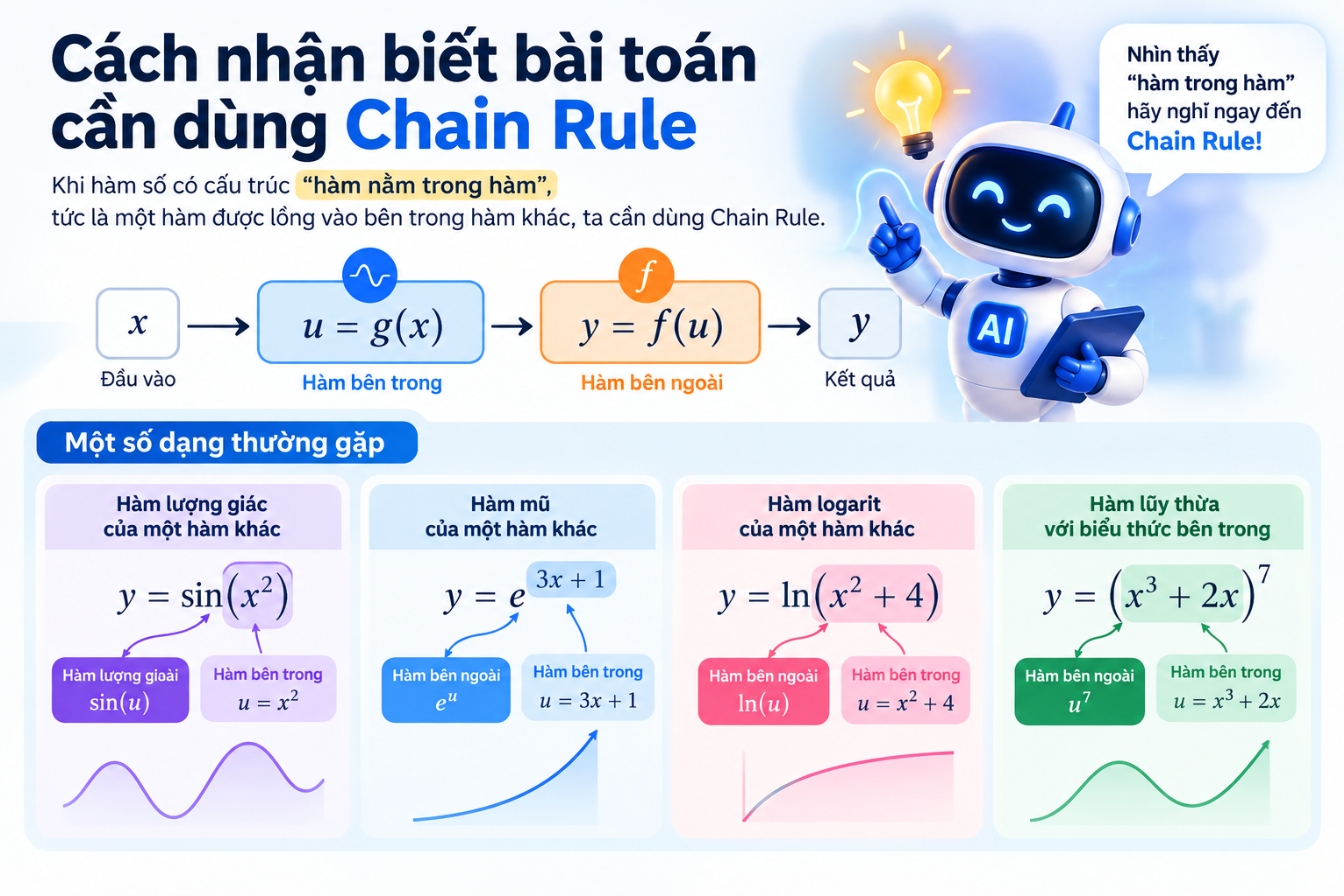
Một dấu hiệu dễ nhận ra là hàm có cấu trúc “hàm nằm trong hàm”.
Ví dụ:
y = sin(x²)
y = e^(3x+1)
y = ln(x² + 4)
y = (x³ + 2x)⁷
Ở y = sin(x²), hàm bên ngoài là sin(u), còn hàm bên trong là u = x².
Ta có:
y’ = cos(x²) × 2x
hay:
y’ = 2x cos(x²)
Với các biểu thức có nhiều lớp hơn, chain rule có thể được áp dụng liên tiếp từ lớp ngoài vào lớp trong.
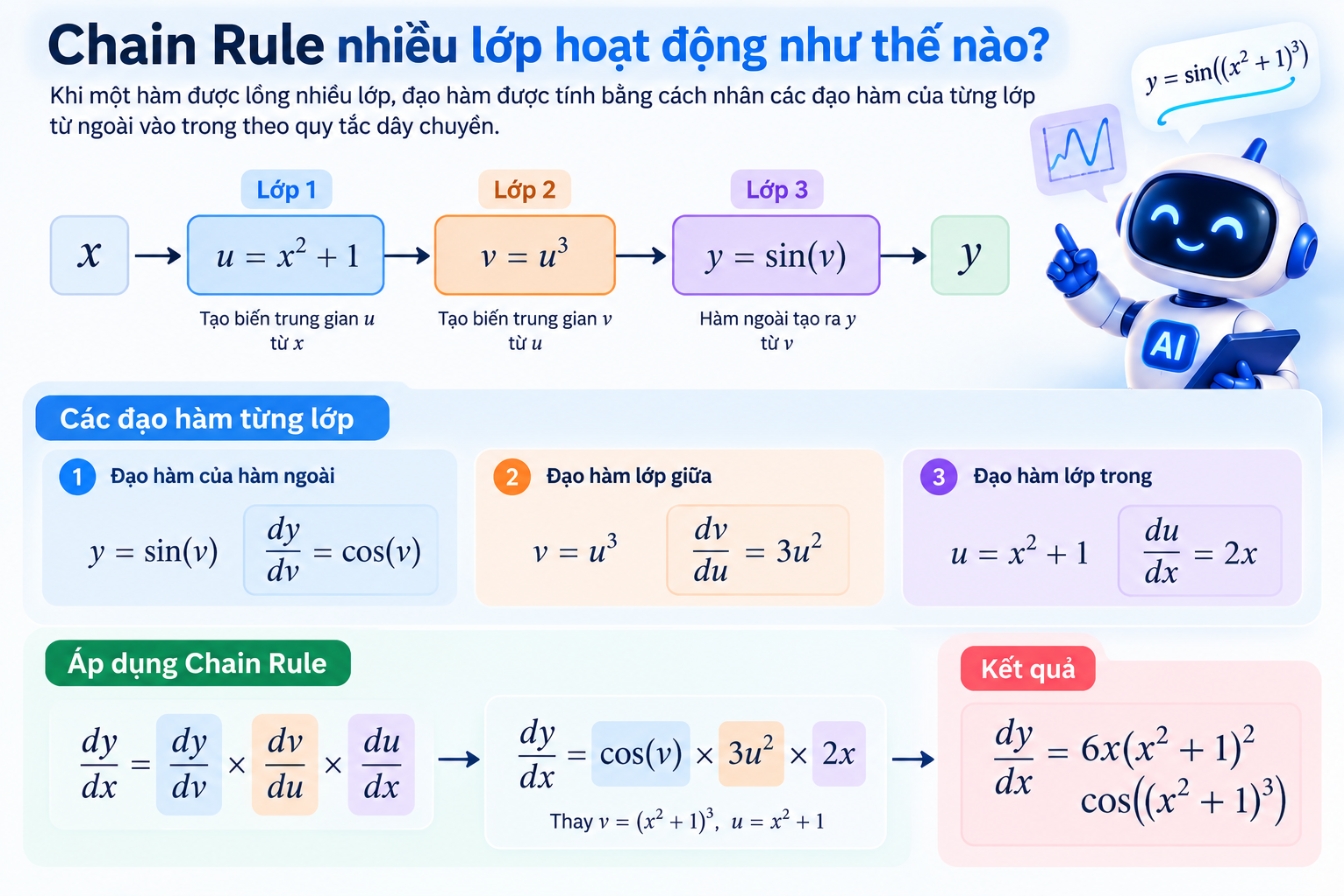
Chain Rule nhiều lớp hoạt động như thế nào?
Xét:
y = sin((x² + 1)³)
Biểu thức này có thể chia thành ba lớp:
u = x² + 1
v = u³
y = sin(v)
Khi đó:
dy/dx = dy/dv × dv/du × du/dx
Ta có:
dy/dv = cos(v)
dv/du = 3u²
du/dx = 2x
Do đó:
dy/dx = cos((x² + 1)³) × 3(x² + 1)² × 2x
Rút gọn:
y’ = 6x(x² + 1)² cos((x² + 1)³)
Cách viết này cho thấy lý do quy tắc có tên “chain”: đạo hàm được truyền qua một chuỗi quan hệ phụ thuộc.
Đây cũng chính là ý tưởng sẽ xuất hiện khi xét computational graph của một mô hình AI.
Chain Rule có liên quan gì đến AI?
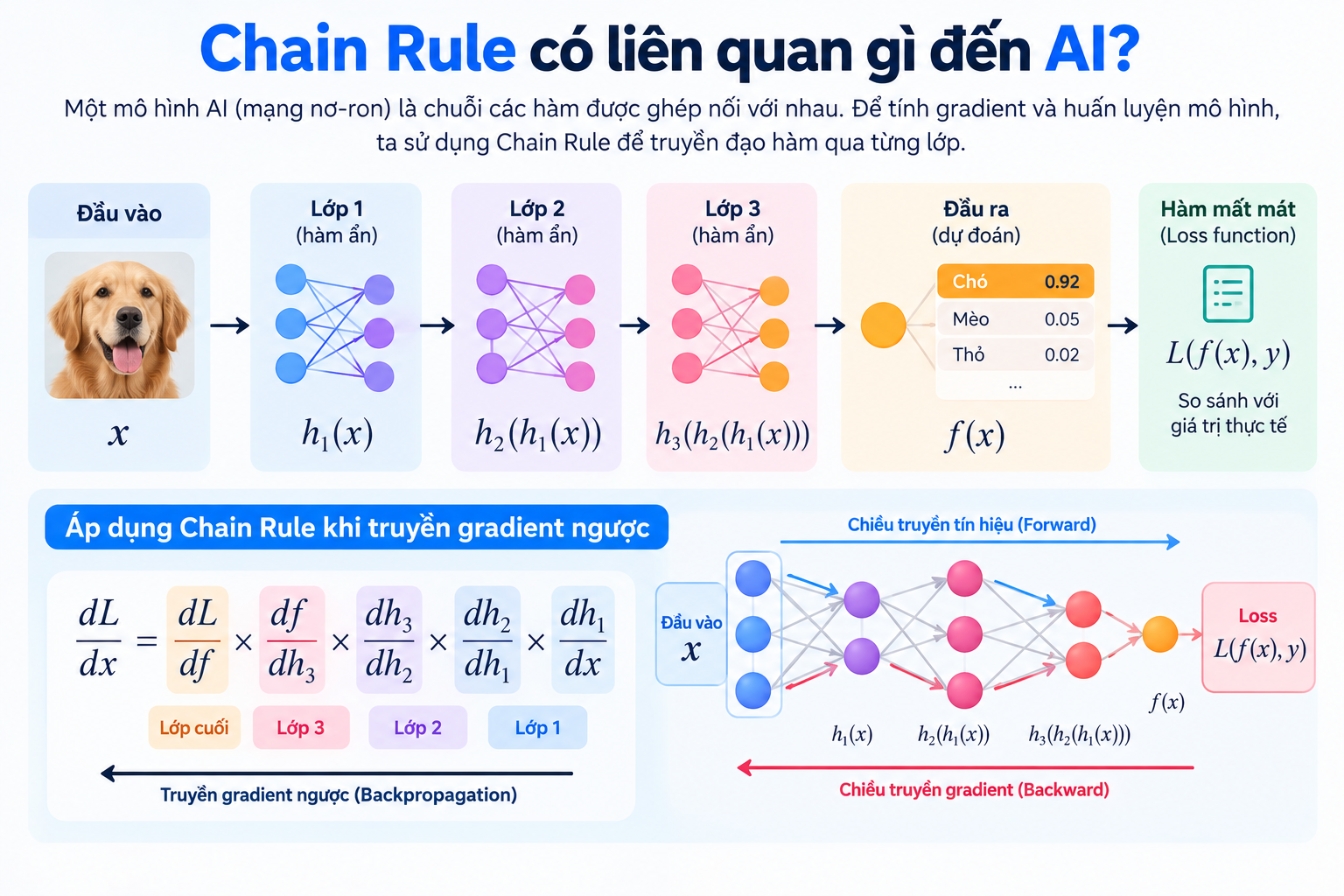
Một neural network có thể được nhìn như tập hợp nhiều hàm được ghép nối với nhau.
Một dạng đơn giản có thể viết:
Input → Layer 1 → Layer 2 → Output → Loss
Mỗi lớp nhận kết quả từ lớp trước, thực hiện phép tính rồi chuyển kết quả sang lớp kế tiếp. Vì vậy, đầu ra cuối cùng là kết quả của nhiều hàm lồng nhau.
Khi mô hình đưa ra dự đoán, loss function đo mức sai lệch giữa dự đoán và giá trị mong muốn. Muốn điều chỉnh mô hình, hệ thống phải biết từng trọng số đã tác động đến loss bao nhiêu.
Đây là lúc chain rule được sử dụng.
Google for Developers giải thích rằng, xét dưới góc độ calculus, backpropagation triển khai chain rule để tính đạo hàm riêng của lỗi theo các tham số trong mạng.
Ví dụ đơn giản về gradient trong AI
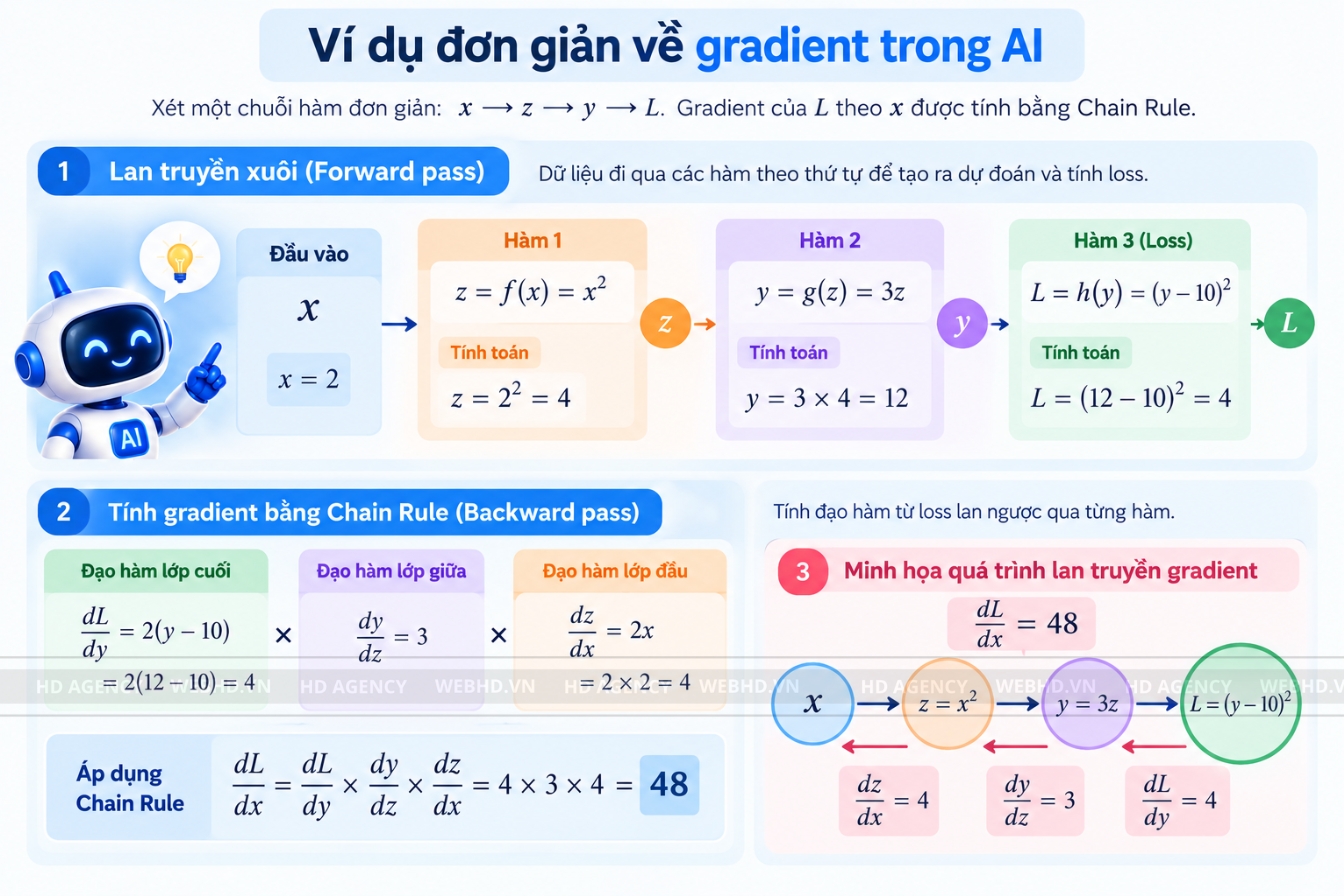
Giả sử có chuỗi:
x → z → y → L
Trong đó:
z = f(x)
y = g(z)
L = h(y)
Muốn biết x ảnh hưởng đến L như thế nào, ta cần:
dL/dx = dL/dy × dy/dz × dz/dx
Thay vì tính trực tiếp một biểu thức lớn, hệ thống có thể tính từng đạo hàm cục bộ rồi kết hợp chúng.
Với mạng có nhiều lớp, ý tưởng vẫn tương tự. Gradient của loss được truyền ngược từ đầu ra về các lớp trước.
Backpropagation sử dụng Chain Rule ra sao?
Backpropagation là phương pháp tính gradient thường được dùng khi huấn luyện neural network.
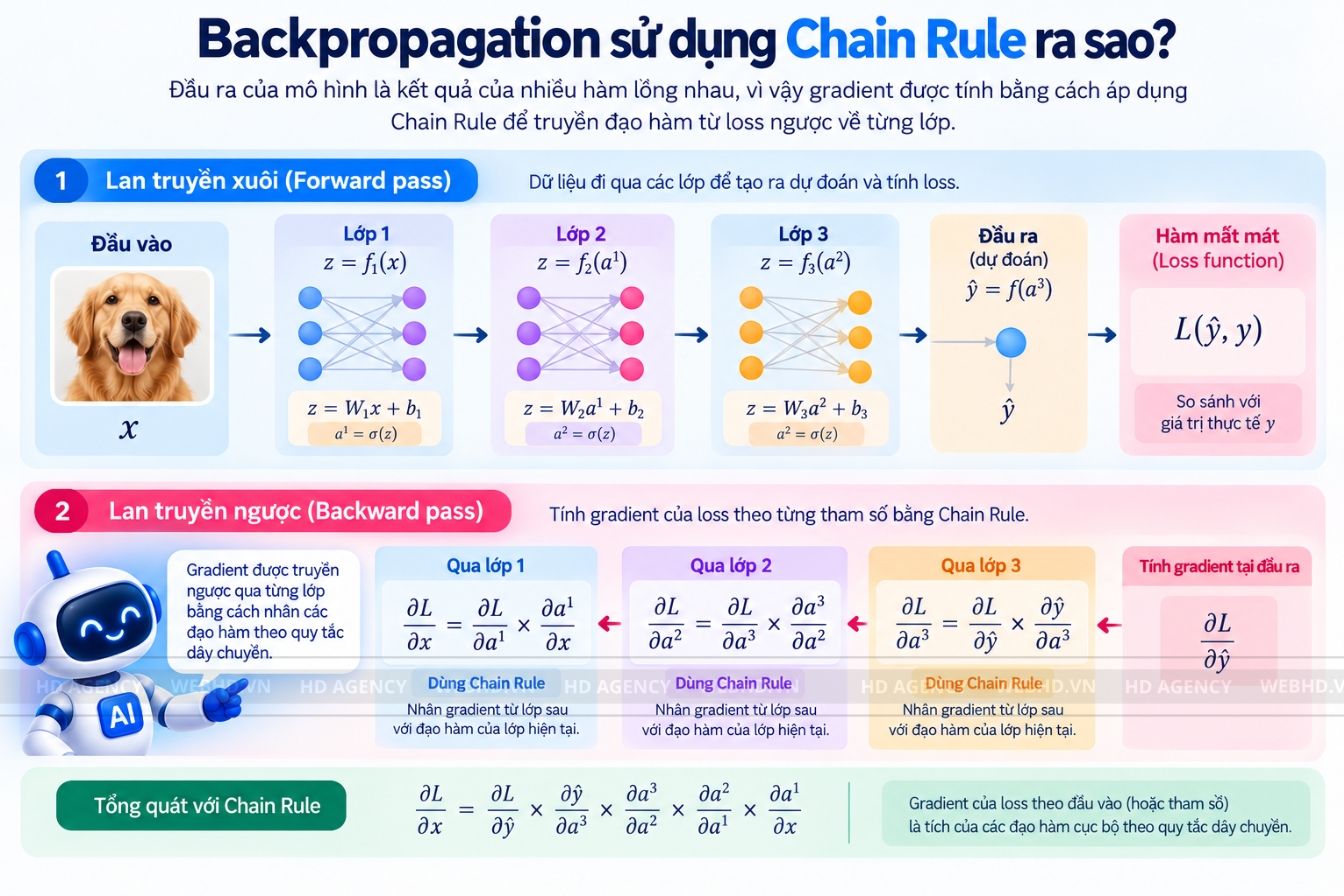
Có thể hình dung quá trình huấn luyện gồm hai chiều tính toán.
Ở lượt forward, dữ liệu đi từ đầu vào qua các lớp để tạo dự đoán và tính loss.
Ở lượt backward, gradient được tính từ loss rồi truyền ngược về các tham số của mạng.
PyTorch mô tả hệ thống autograd bằng một đồ thị có hướng. Khi gọi .backward(), hệ thống tính gradient và sử dụng chain rule để truyền chúng ngược về các tensor đầu vào cần theo dõi. Tài liệu Autograd của PyTorch được cập nhật tháng 8/2026 vẫn mô tả cơ chế reverse automatic differentiation theo nguyên tắc này.
Điều đó có nghĩa lập trình viên thường không cần tự viết từng phép chain rule khi huấn luyện model bằng framework hiện đại. Framework đảm nhận phần lớn việc xây dựng computational graph và tính gradient tự động.
Tuy nhiên, hiểu nguyên tắc vẫn hữu ích khi cần đọc kiến trúc mạng, viết custom operation, kiểm tra gradient hoặc xử lý lỗi liên quan đến autograd.
Automatic Differentiation và Chain Rule
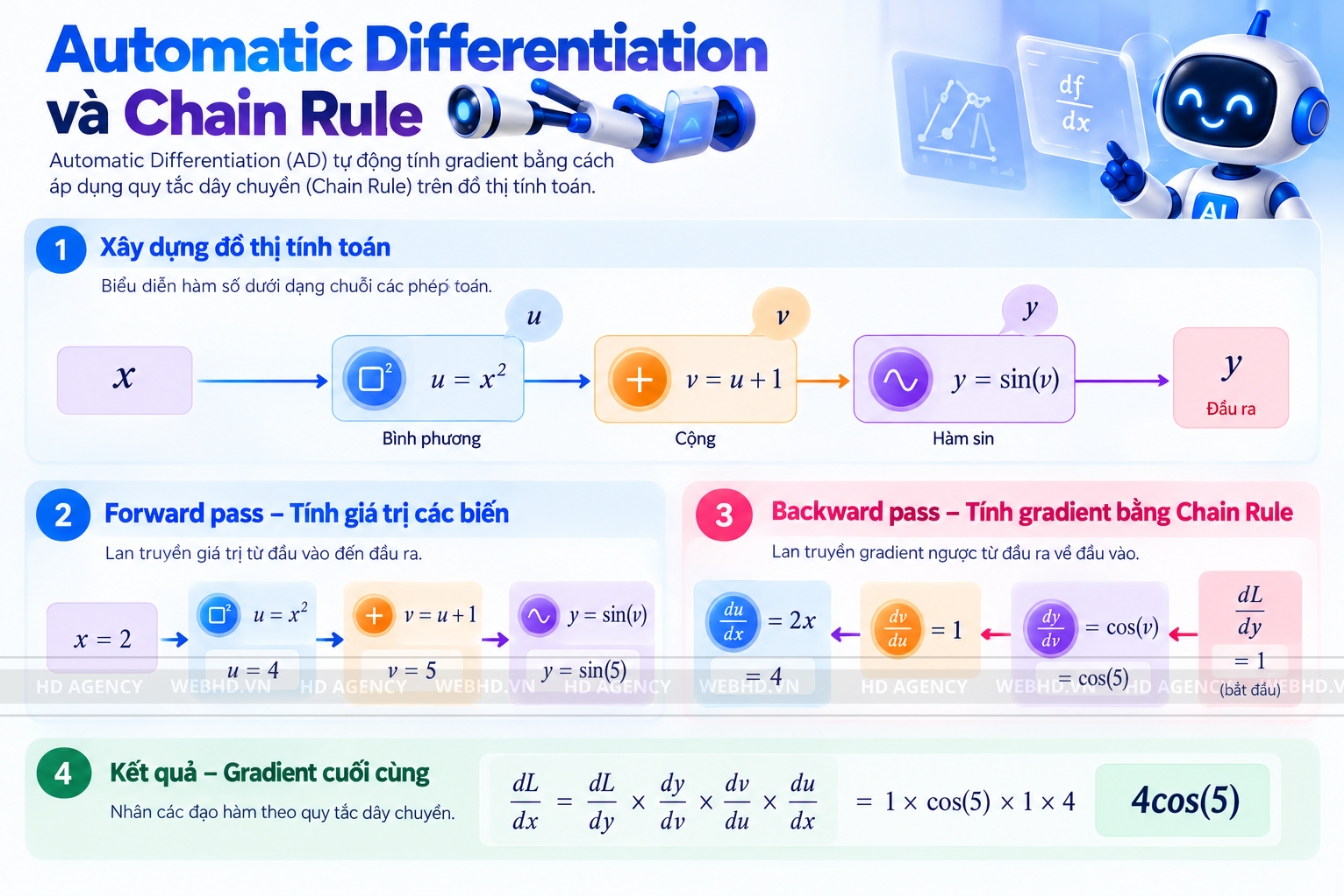
Automatic differentiation không đơn thuần là lấy một công thức đạo hàm đã có sẵn. Hệ thống chia phép tính thành các operation nhỏ, biết đạo hàm cục bộ của từng operation rồi kết hợp chúng theo computational graph.
PyTorch cho biết autograd ghi lại các operation trong một directed acyclic graph. Khi backward pass chạy, gradient được truyền từ phần output về các tensor đầu vào bằng chain rule.
Ví dụ:
a = x²
b = 3a
c = sin(b)
Thay vì xử lý c như một biểu thức nguyên khối, hệ thống có thể theo dõi:
x → a → b → c
Sau đó tính:
dc/db
db/da
da/dx
và kết hợp:
dc/dx = dc/db × db/da × da/dx
Đây là một lý do chain rule vẫn có vai trò trực tiếp trong các thư viện machine learning dù người dùng hiếm khi phải tự tính bằng tay.
Quotient Rule là gì?
Bên cạnh câu hỏi chain rule là gì, một khái niệm thường xuất hiện cùng chủ đề đạo hàm là quotient rule là gì.
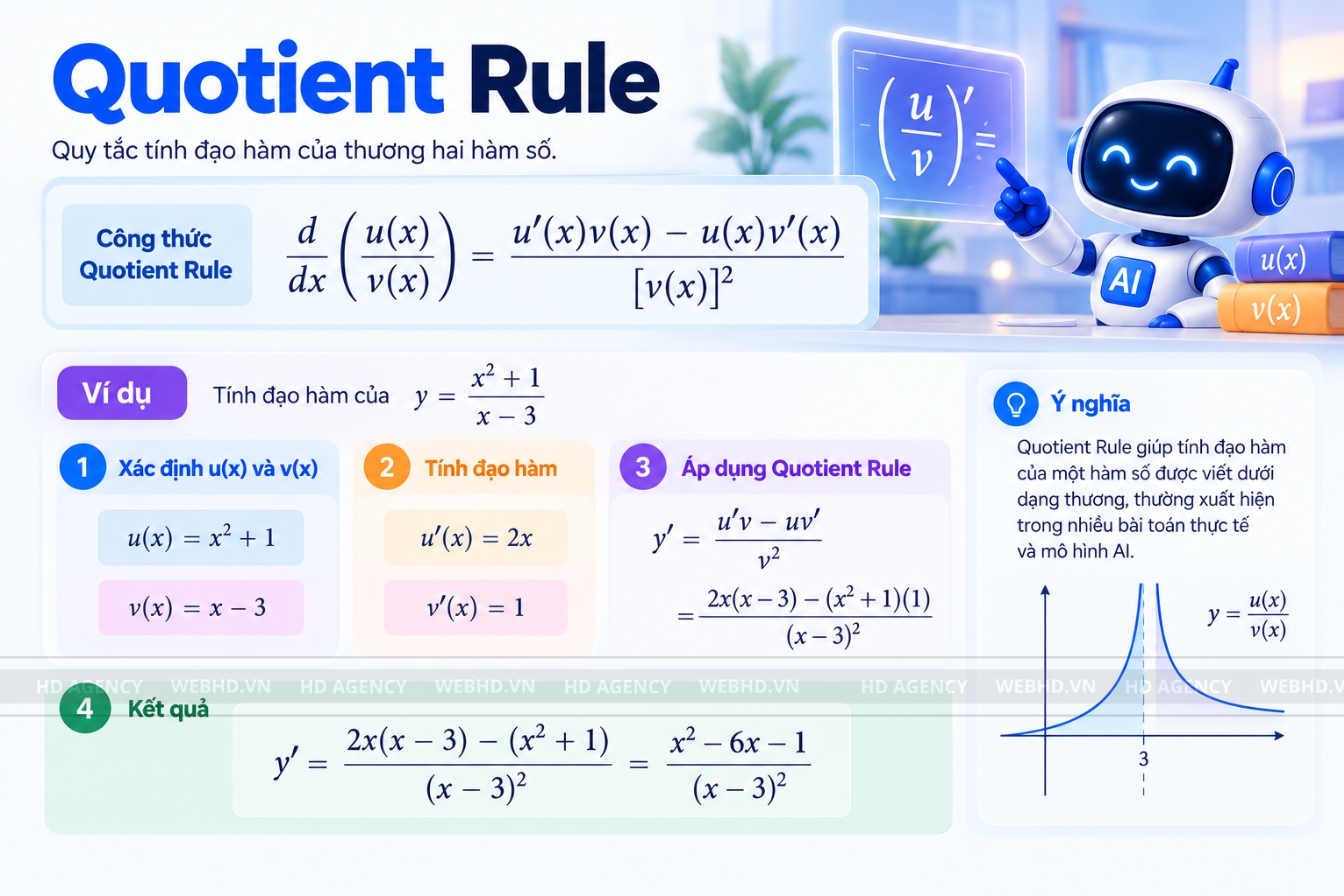
Quotient rule, hay quy tắc thương, được sử dụng để tính đạo hàm của thương giữa hai hàm.
Nếu:
y = f(x) / g(x)
với g(x) ≠ 0, thì:
y’ = [f'(x)g(x) – f(x)g'(x)] / [g(x)]²
Quy tắc này khác chain rule ở loại cấu trúc mà nó xử lý.
Chain rule dùng cho hàm hợp:
f(g(x))
Quotient rule dùng cho thương:
f(x) / g(x)
Khan Academy cũng chỉ ra rằng quotient rule có thể được suy ra từ product rule kết hợp với chain rule khi viết phép chia dưới dạng nhân với nghịch đảo.
Ví dụ về Quotient Rule
Cho:
y = x² / (x + 1)
Đặt:
f(x) = x²
g(x) = x + 1
Ta có:
f'(x) = 2x
g'(x) = 1
Áp dụng quotient rule:
y’ = [2x(x + 1) – x²] / (x + 1)²
Rút gọn:
y’ = (x² + 2x) / (x + 1)²
với x ≠ -1.
Điều kiện của mẫu số ban đầu vẫn cần được giữ lại khi xét miền xác định.
Khi nào phải dùng cả Chain Rule và Quotient Rule?
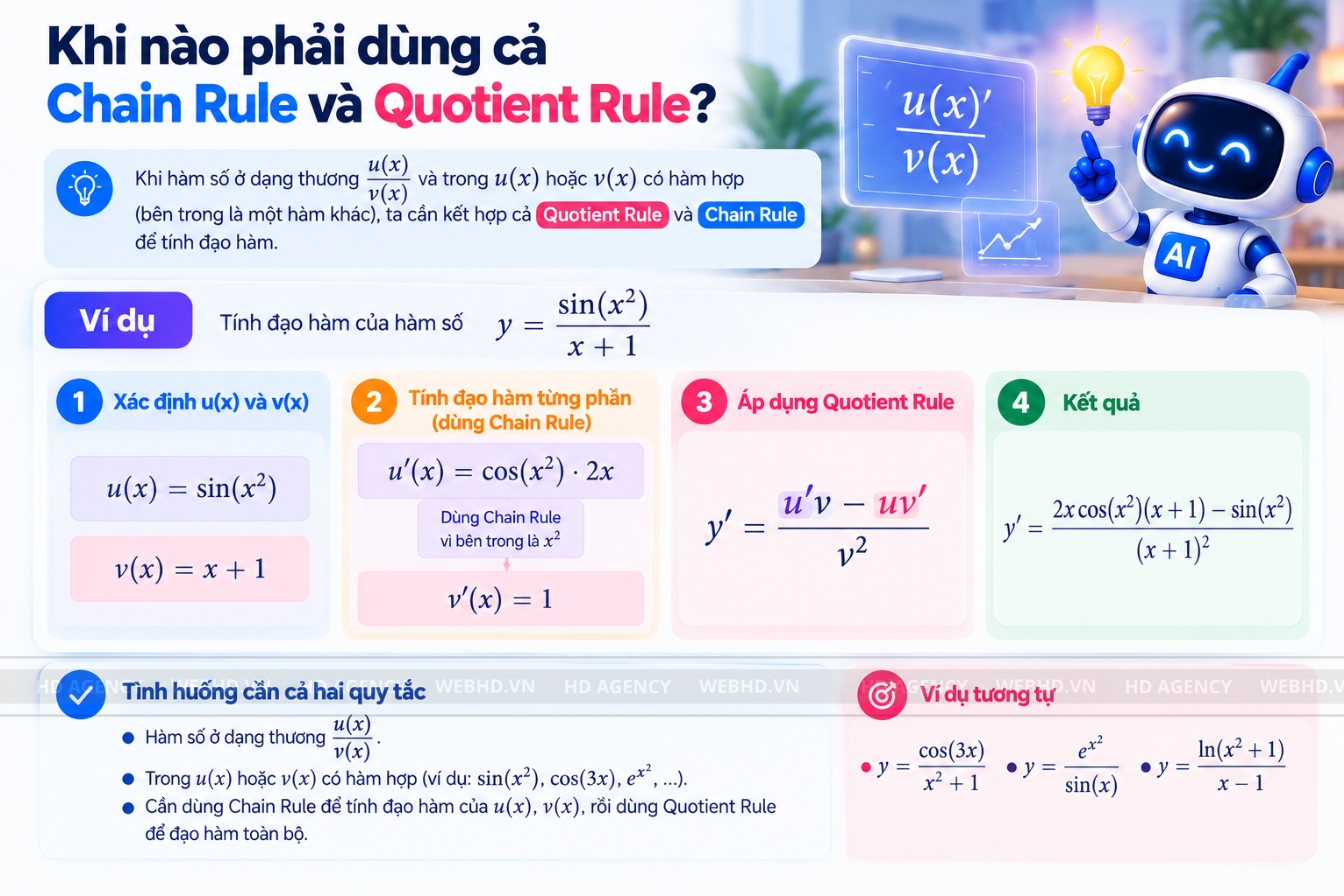
Hai quy tắc không loại trừ nhau. Một biểu thức có thể cần cả hai.
Ví dụ:
y = sin(x²) / (x + 1)³
Ở cấp ngoài, đây là một phép chia nên có thể áp dụng quotient rule.
Nhưng khi tính đạo hàm tử số:
d/dx[sin(x²)] = cos(x²) × 2x
ta cần chain rule.
Đạo hàm mẫu số:
d/dx[(x + 1)³] = 3(x + 1)²
cũng dùng chain rule.
Sai sót thường gặp là người học xác định đúng quotient rule ở lớp ngoài nhưng lại quên tiếp tục lấy đạo hàm đầy đủ của các hàm hợp bên trong.
Chain Rule có phải chỉ dành cho người học toán?
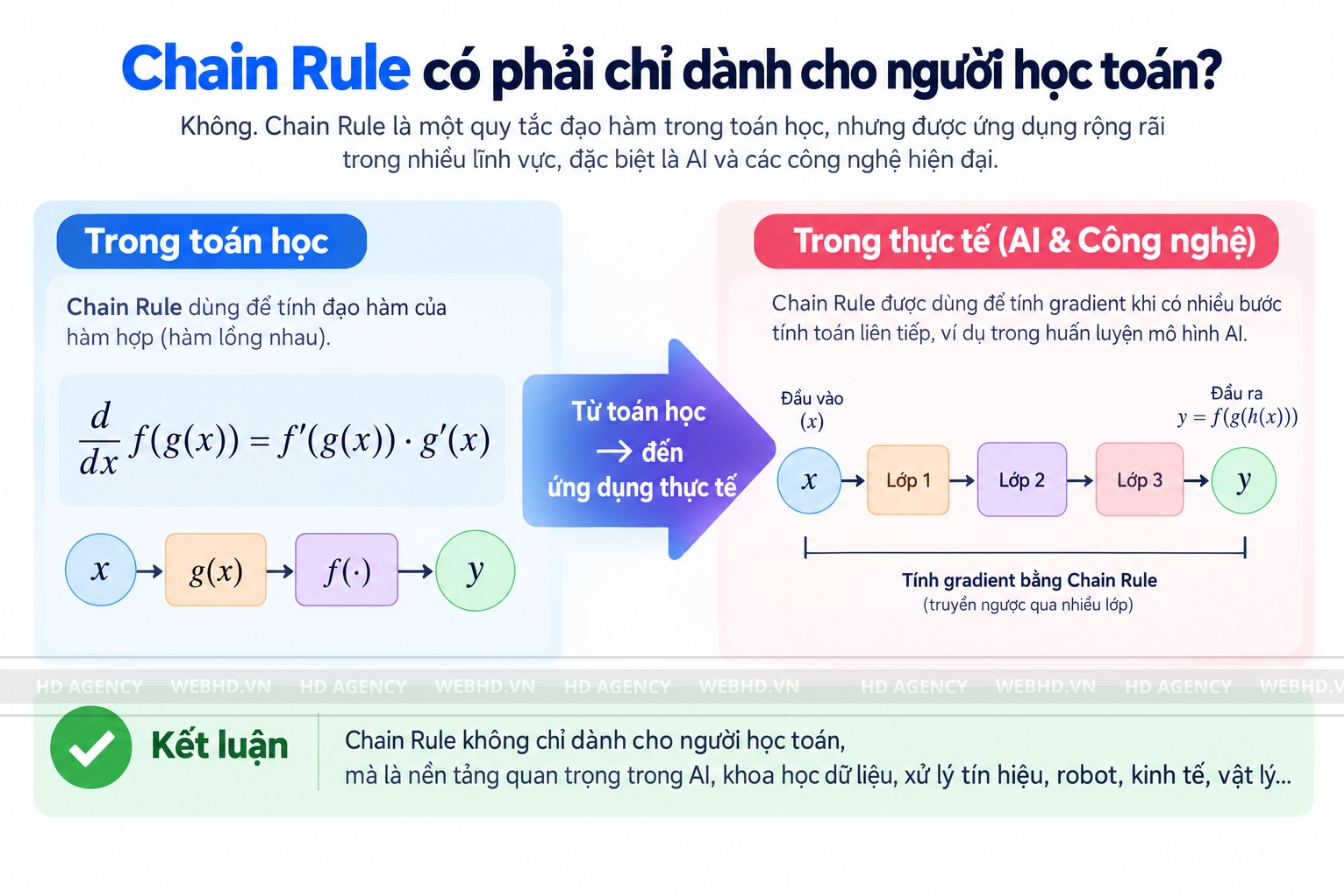
Không. Nếu chỉ sử dụng các công cụ AI có sẵn, người dùng không bắt buộc phải tự tính chain rule.
Nhưng với người học machine learning, deep learning hoặc muốn hiểu backpropagation, đây là kiến thức nền đáng học. Google đưa chain rule vào nhóm kiến thức calculus giúp người học hiểu đầy đủ hơn thuật toán backpropagation dùng để huấn luyện neural network.
Kiến thức này đặc biệt hữu ích khi tìm hiểu:
gradient descent;
loss function;
computational graph;
automatic differentiation;
backpropagation;
deep neural network.
Chain rule giúp trả lời một câu hỏi rất cụ thể: khi một biến nằm sâu bên trong chuỗi phép tính thay đổi, kết quả cuối cùng thay đổi bao nhiêu?
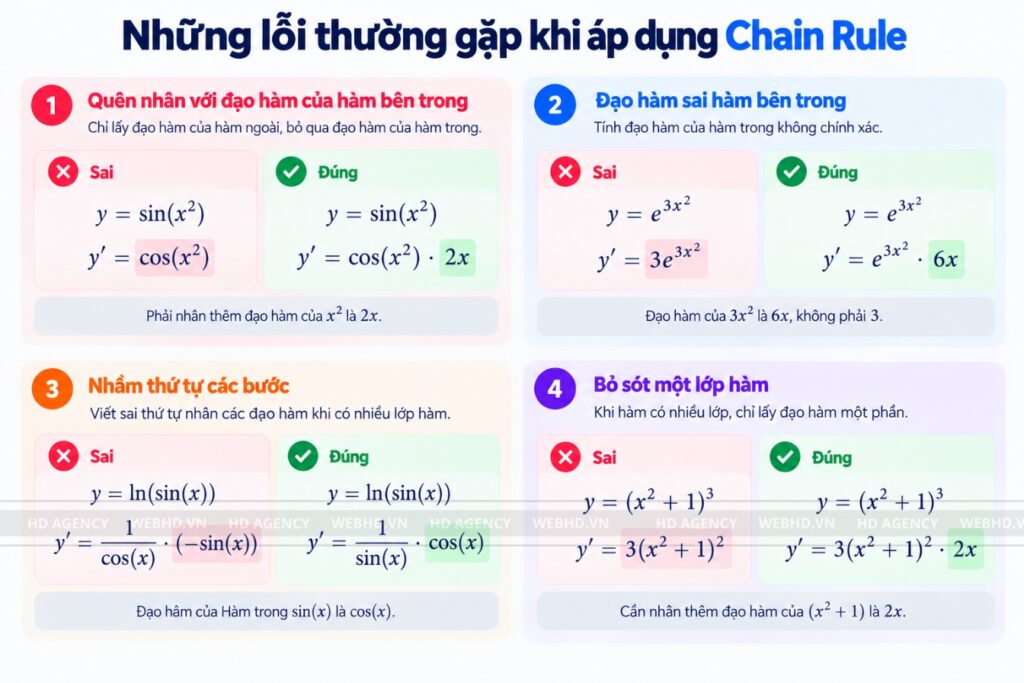
Những lỗi thường gặp khi áp dụng Chain Rule
Lỗi phổ biến là chỉ lấy đạo hàm hàm ngoài rồi dừng lại.
Ví dụ:
y = (x² + 1)⁵
Viết:
y’ = 5(x² + 1)⁴
là chưa đủ.
Cần nhân thêm đạo hàm của x² + 1:
y’ = 10x(x² + 1)⁴
Một lỗi khác là xác định sai lớp hàm. Với biểu thức phức tạp, nên viết các biến trung gian u, v hoặc t trước khi lấy đạo hàm.
Người học cũng dễ nhầm chain rule với product rule và quotient rule. Cách phân biệt khá rõ: hàm lồng nhau dùng chain rule; hai hàm nhân nhau dùng product rule; hai hàm chia nhau dùng quotient rule. Một bài toán có thể đồng thời chứa nhiều cấu trúc nên phải kết hợp nhiều quy tắc.
Vì sao Chain Rule vẫn quan trọng khi framework đã tự tính gradient?
TensorFlow, PyTorch và các thư viện machine learning hiện nay đã tự động hóa phần lớn phép tính gradient. Điều đó không làm chain rule mất đi vai trò. Ngược lại, chính các hệ thống automatic differentiation đang thực hiện các phép tính mà lập trình viên trước đây phải xử lý thủ công.
Google ghi nhận rằng các API machine learning hiện đại như Keras có thể triển khai backpropagation thay cho việc người phát triển tự viết toàn bộ phép tính.
Vì vậy, mục tiêu khi học chain rule trong AI không phải là ngồi tính hàng triệu đạo hàm bằng tay. Giá trị của nó nằm ở việc hiểu gradient đến từ đâu, vì sao có thể truyền ngược qua nhiều lớp và tại sao một tham số ở lớp trước vẫn có thể ảnh hưởng đến loss ở cuối mạng.
Kết luận
Chain rule là quy tắc tính đạo hàm của hàm hợp. Công thức cơ bản có thể viết:
dy/dx = dy/du × du/dx
Từ một kiến thức của calculus, chain rule trở thành thành phần toán học quan trọng của backpropagation và automatic differentiation. Các framework như PyTorch có thể xây dựng computational graph, tính gradient và truyền gradient ngược qua các operation dựa trên nguyên tắc này.
Trong khi đó, nếu thắc mắc quotient rule là gì, đây là quy tắc dành cho đạo hàm của thương hai hàm. Hai quy tắc phục vụ những cấu trúc khác nhau nhưng hoàn toàn có thể xuất hiện trong cùng một biểu thức.
Câu hỏi thường gặp về Chain Rule
Chain Rule là gì?
Chain Rule là quy tắc dùng để tính đạo hàm của hàm hợp, tức một hàm nằm bên trong một hàm khác. Công thức cơ bản là: f′(g(x))×g′(x)f'(g(x)) \times g'(x).
Khi nào cần sử dụng Chain Rule?
Chain Rule được dùng khi biểu thức có nhiều lớp hàm, chẳng hạn sin(x2)\sin(x^2), (x2+1)5(x^2+1)^5 hoặc e3x+1e^{3x+1}.
Chain Rule có vai trò gì trong AI?
Chain Rule giúp tính gradient qua nhiều lớp của mô hình. Đây là nguyên tắc toán học được sử dụng trong backpropagation để hỗ trợ quá trình huấn luyện mạng nơ-ron.
Quotient Rule là gì?
Quotient Rule là quy tắc tính đạo hàm của thương hai hàm. Nếu y=f(x)/g(x)y=f(x)/g(x), công thức là y′=[f′g−fg′]/g2y’=[f’g-fg’]/g^2, với g(x)≠0g(x)\neq0.
Chain Rule và Quotient Rule khác nhau thế nào?
Chain Rule dùng cho hàm hợp, còn Quotient Rule dùng cho phép chia giữa hai hàm. Một biểu thức có thể cần kết hợp cả hai nếu chứa đồng thời hàm hợp và phép chia.