Google có thể lập chỉ mục hàng tỷ trang web nhờ một quy trình tự động gọi là crawling. Đây là bước đầu tiên giúp công cụ tìm kiếm phát hiện nội dung mới, cập nhật các thay đổi trên website và quyết định những trang nào đủ điều kiện xuất hiện trên kết quả tìm kiếm. Tuy nhiên, không phải mọi dữ liệu trên website đều cần được Google thu thập.
Google liên tục thu thập dữ liệu từ hàng tỷ website mỗi ngày. Cùng HD Agency tìm hiểu crawl là gì và cách tối ưu quá trình này để cải thiện hiệu quả SEO.
Crawl là gì?
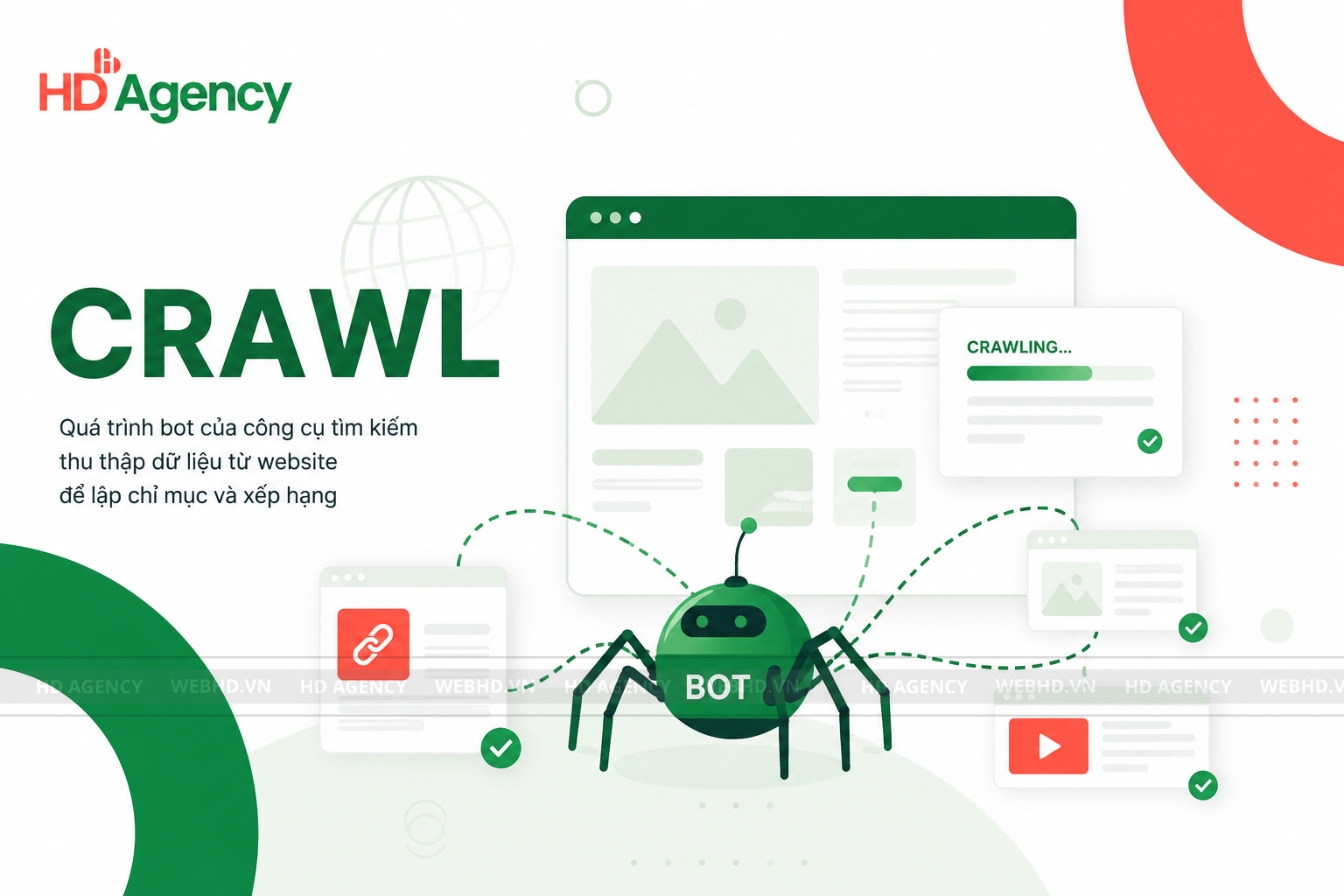
Crawl là quá trình các bot của công cụ tìm kiếm (hay còn gọi là crawler hoặc spider) tự động truy cập vào website để khám phá nội dung, đọc mã nguồn, theo dõi các liên kết và thu thập thông tin về từng trang web.
Đối với Google, bot thực hiện nhiệm vụ này có tên là Googlebot. Khi Googlebot truy cập website, nó sẽ lần lượt đi qua các đường dẫn nội bộ, đọc nội dung văn bản, hình ảnh, video, dữ liệu có cấu trúc và nhiều thành phần khác để hiểu nội dung của từng trang.
Quá trình crawling là bước đầu tiên trước khi Google lập chỉ mục (Index) và xếp hạng (Ranking). Nếu một trang không được crawl thì gần như Google sẽ không thể index và cũng không thể xuất hiện trên kết quả tìm kiếm.
Đối với doanh nghiệp đang đầu tư website để phát triển khách hàng, việc tối ưu SEO kỹ thuật ngay từ đầu sẽ giúp Google thu thập dữ liệu hiệu quả hơn. Đây cũng là lý do nhiều doanh nghiệp lựa chọn dịch vụ SEO của HD Agency nhằm xây dựng cấu trúc website chuẩn, tối ưu khả năng crawl và index, đồng thời cải thiện hiệu quả tìm kiếm tự nhiên theo hướng bền vững.
Crawl hoạt động như thế nào?
Thông thường, Googlebot sẽ:
- Bắt đầu từ các URL đã biết.
- Theo dõi liên kết sang các trang khác.
- Đọc nội dung trang.
- Phân tích mã HTML.
- Gửi dữ liệu về hệ thống Google để xử lý.
- Tiếp tục khám phá các URL mới.
Nếu website có cấu trúc rõ ràng, tốc độ tải nhanh và hệ thống liên kết nội bộ hợp lý thì Googlebot sẽ thu thập dữ liệu hiệu quả hơn.
Googlebot là gì?
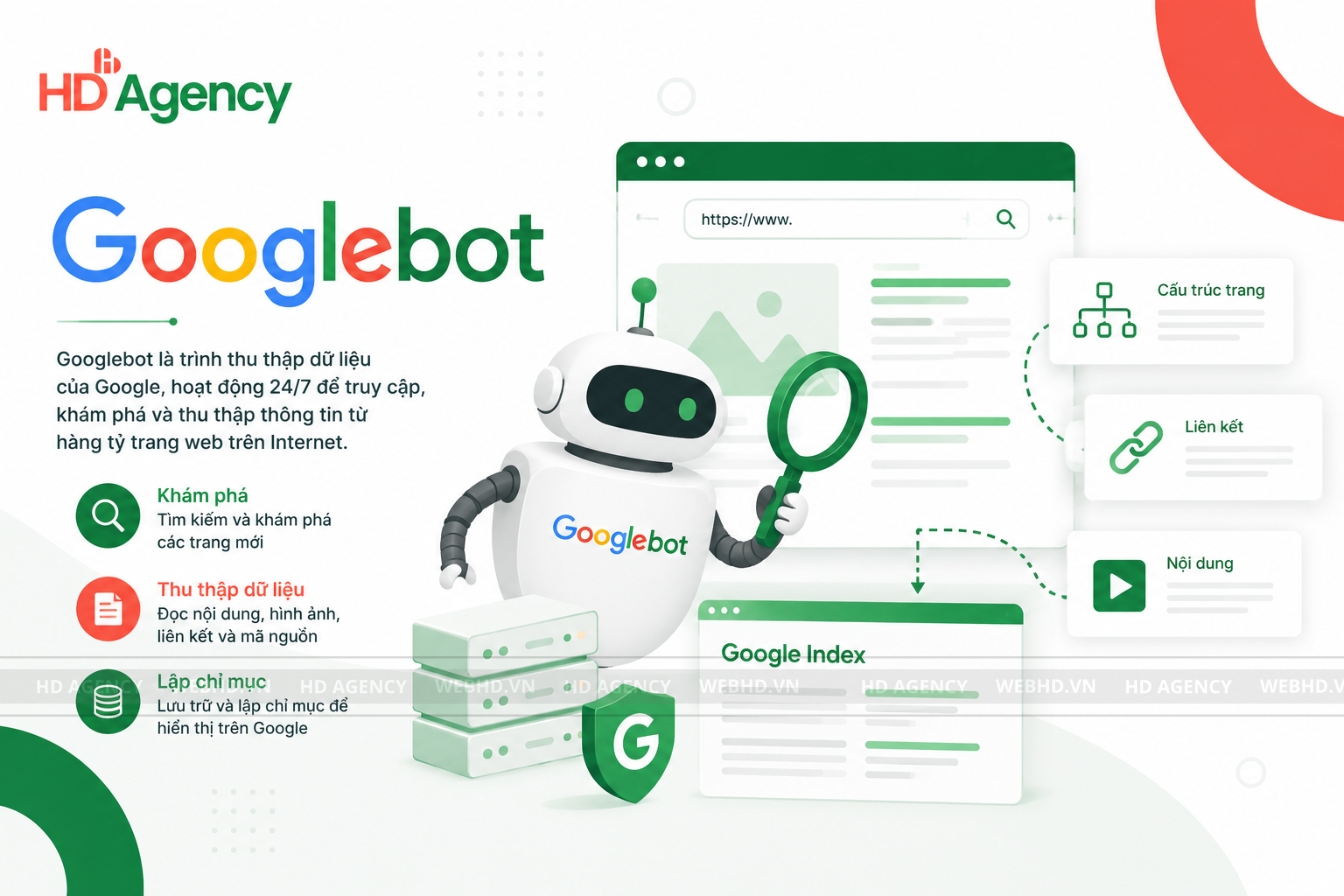
Googlebot là chương trình tự động của Google chịu trách nhiệm thu thập dữ liệu trên Internet.
Googlebot hoạt động liên tục 24/7 và luôn cập nhật các website mới hoặc những trang có nội dung thay đổi. Tần suất crawl phụ thuộc vào nhiều yếu tố như:
- Độ uy tín của website.
- Mức độ cập nhật nội dung.
- Tốc độ phản hồi của máy chủ.
- Crawl Budget được Google phân bổ.
- Chất lượng cấu trúc website.
Crawl là gì trong SEO?
Trong SEO, crawl là bước đầu tiên của toàn bộ quy trình xuất hiện trên Google.
Một website thường trải qua ba giai đoạn:
- Crawl (Thu thập dữ liệu)
- Index (Lập chỉ mục)
- Ranking (Xếp hạng)
Nếu website gặp lỗi ở bước crawl thì những bước phía sau cũng sẽ bị ảnh hưởng.
Ví dụ:
Bạn vừa đăng một bài viết mới nhưng Googlebot chưa crawl đến trang đó thì bài viết vẫn chưa được index. Điều này khiến nội dung chưa thể xuất hiện khi người dùng tìm kiếm.
Crawl Budget là gì?
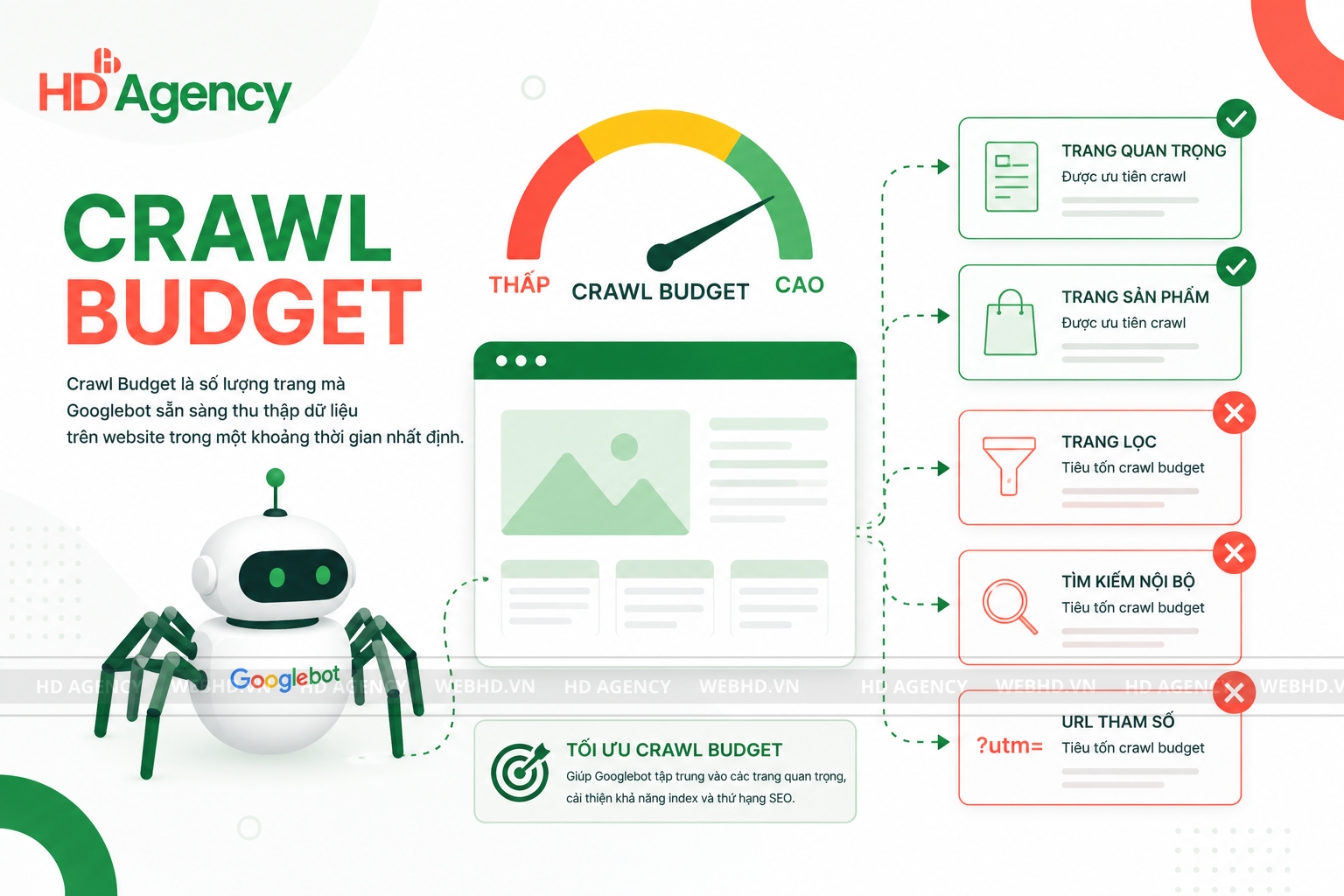
Crawl Budget là số lượng URL mà Googlebot sẵn sàng thu thập trên một website trong một khoảng thời gian nhất định.
Website càng lớn thì việc tối ưu Crawl Budget càng quan trọng.
Nếu Google phải mất nhiều thời gian để crawl:
- Trang lọc sản phẩm
- Trang tìm kiếm nội bộ
- URL tham số
- Trang trùng lặp
Thì những bài viết hoặc landing page quan trọng có thể bị crawl chậm hơn.
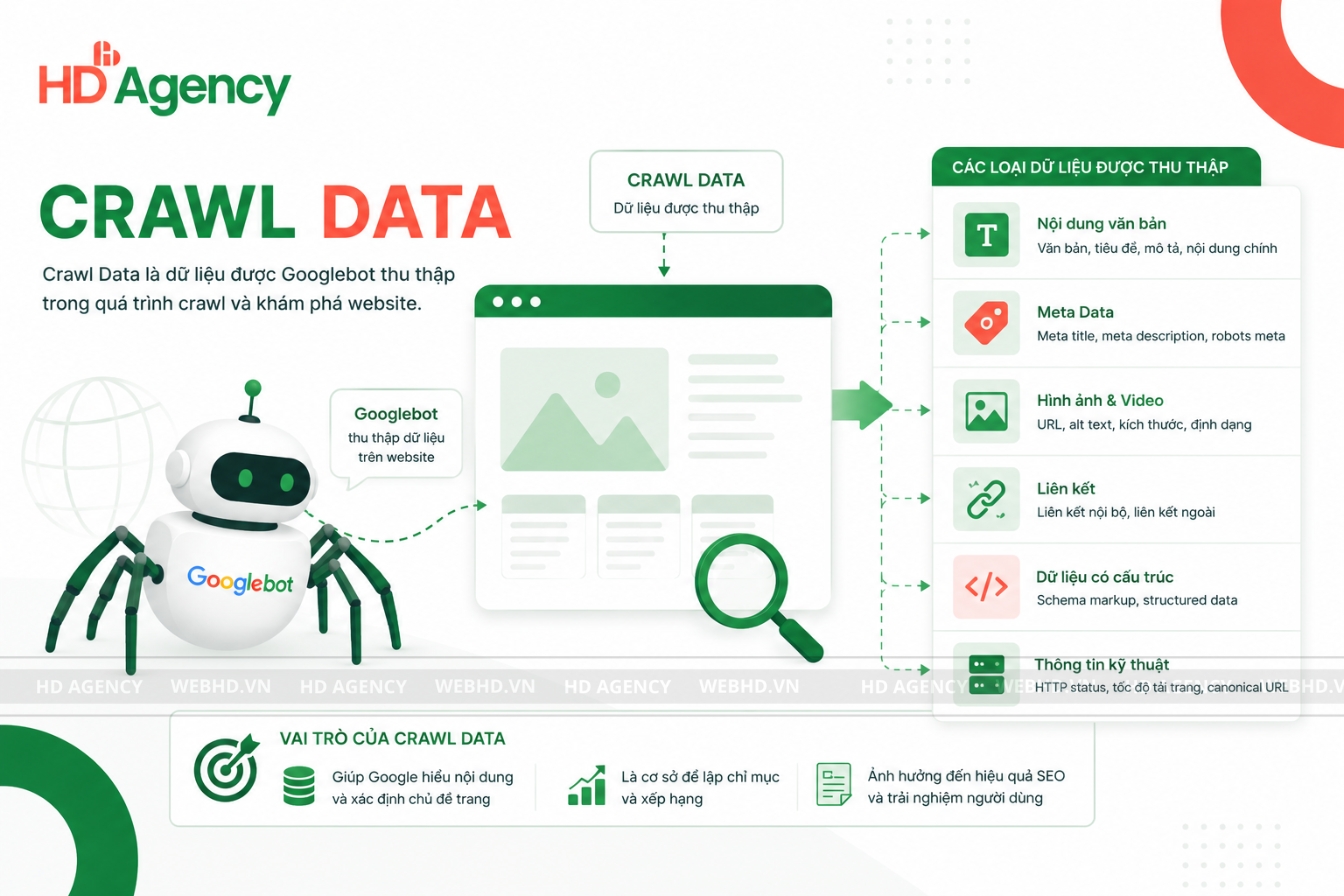
Crawl Data là gì?
Nhiều người khi tìm hiểu SEO thường đặt câu hỏi crawl data là gì.
Hiểu đơn giản, crawl data là dữ liệu được crawler thu thập trong quá trình truy cập website.
Dữ liệu này có thể bao gồm:
- Nội dung văn bản.
- Tiêu đề.
- Meta Title.
- Meta Description.
- Hình ảnh.
- Video.
- Structured Data.
- Liên kết nội bộ.
- Liên kết ngoài.
- Thông tin tốc độ tải.
- Thông tin HTTP Status.
- Canonical URL.
- Robots Meta.
Google sẽ sử dụng toàn bộ dữ liệu đã thu thập để phân tích và quyết định cách lập chỉ mục website.
Vì sao crawl data quan trọng?
Chất lượng dữ liệu thu thập càng tốt thì Google càng hiểu đúng nội dung website.
Ngược lại, nếu crawler gặp:
- Nội dung trùng lặp.
- Trang lỗi.
- Chuyển hướng phức tạp.
- Thiếu liên kết nội bộ.
- Robots cấu hình sai.
Thì khả năng index cũng sẽ giảm theo.
Crawl khác Index như thế nào?
Rất nhiều người nhầm lẫn giữa Crawl và Index.
| Crawl | Index |
| Thu thập dữ liệu | Lưu dữ liệu vào cơ sở dữ liệu Google |
| Googlebot thực hiện | Hệ thống Index của Google xử lý |
| Là bước đầu tiên | Là bước thứ hai |
| Chưa chắc xuất hiện trên Google | Có khả năng xuất hiện khi tìm kiếm |
Một trang được crawl chưa đồng nghĩa sẽ được index.
Google chỉ index những nội dung đáp ứng tiêu chuẩn về chất lượng và mang lại giá trị cho người dùng.
Vì sao cần ngăn Google crawling dữ liệu không quan trọng?
Không phải mọi URL trên website đều cần Google thu thập.
Một số loại trang nếu bị crawl quá nhiều sẽ làm giảm hiệu quả Crawl Budget.
Ví dụ:
- Trang đăng nhập.
- Trang quản trị.
- Trang giỏ hàng.
- Trang thanh toán.
- Trang tìm kiếm.
- Trang lọc sản phẩm.
- URL chứa tham số.
- Trang test.
- Trang cảm ơn sau khi gửi form.
Việc giới hạn Googlebot truy cập các URL này sẽ giúp bot tập trung hơn vào:
- Bài viết.
- Danh mục.
- Landing page.
- Trang sản phẩm.
- Trang dịch vụ.
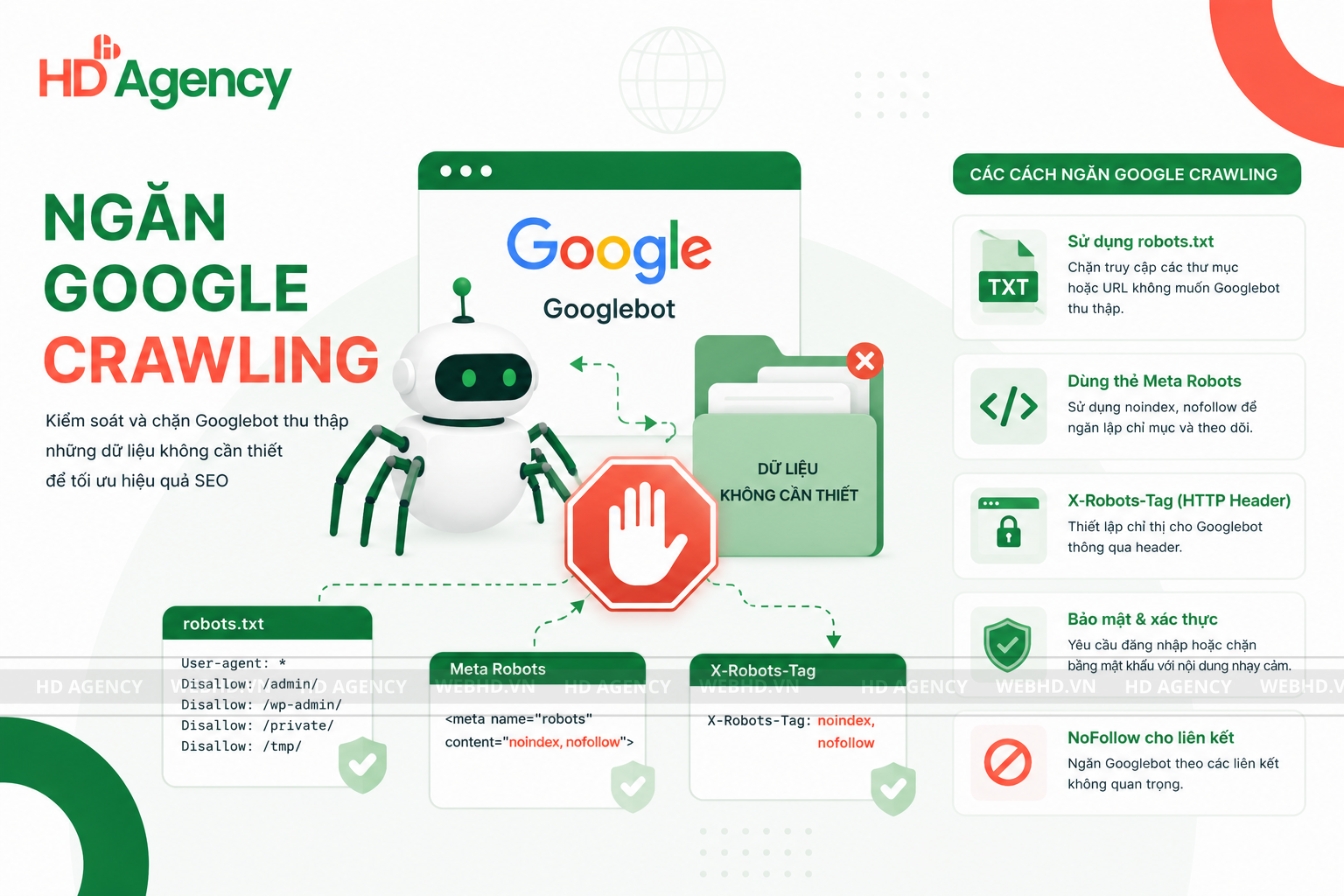
Cách ngăn Google crawling dữ liệu không quan trọng
Có nhiều phương pháp giúp hạn chế Googlebot thu thập những trang không cần thiết.
Sử dụng robots.txt
Đây là cách phổ biến để yêu cầu crawler không truy cập vào một số thư mục hoặc URL.
Ví dụ:
User-agent: *
Disallow: /search/
Disallow: /cart/
Disallow: /checkout/
Lưu ý rằng robots.txt chỉ ngăn việc crawl chứ không đảm bảo URL sẽ không xuất hiện trên Google nếu vẫn có liên kết từ bên ngoài trỏ đến.
Dùng thẻ Meta Robots
Bạn có thể thêm:
<meta name=”robots” content=”noindex, follow”>
Hoặc
<meta name=”robots” content=”noindex, nofollow”>
Để kiểm soát việc lập chỉ mục và theo dõi liên kết.
Thiết lập Canonical
Canonical giúp Google hiểu đâu là phiên bản chính của nội dung.
Điều này đặc biệt hữu ích với:
- URL tham số.
- Bộ lọc sản phẩm.
- Phiên bản có tracking.
Canonical góp phần giảm việc Google xử lý các nội dung trùng lặp.
Chỉ đưa URL quan trọng vào Sitemap
XML Sitemap nên chỉ chứa:
- Bài viết.
- Danh mục.
- Landing page.
- Trang sản phẩm.
- Trang dịch vụ.
Không nên đưa các URL không cần index vào Sitemap.
Hạn chế tạo URL trùng lặp
Một website có quá nhiều URL sinh tự động sẽ khiến Google phải crawl rất nhiều nội dung gần giống nhau.
Điều này thường xảy ra ở:
- Website thương mại điện tử.
- Website nhiều bộ lọc.
- Website nhiều tham số URL.
Những lỗi khiến Google crawl kém hiệu quả
Một số lỗi phổ biến bao gồm:
Website quá chậm
Máy chủ phản hồi chậm khiến Googlebot giảm tần suất crawl.
Internal Link chưa tối ưu
Nếu bài viết không có liên kết nội bộ thì Googlebot sẽ khó khám phá các trang mới.
Quá nhiều lỗi 404
Các URL lỗi làm giảm hiệu quả thu thập dữ liệu và ảnh hưởng đến trải nghiệm của crawler.
Chuyển hướng nhiều tầng
Chuỗi Redirect dài khiến Googlebot mất thêm thời gian xử lý.
Nội dung trùng lặp
Website có nhiều trang giống nhau sẽ khiến Crawl Budget bị lãng phí.
Cách kiểm tra Google đang crawl website
Bạn có thể sử dụng các công cụ sau:
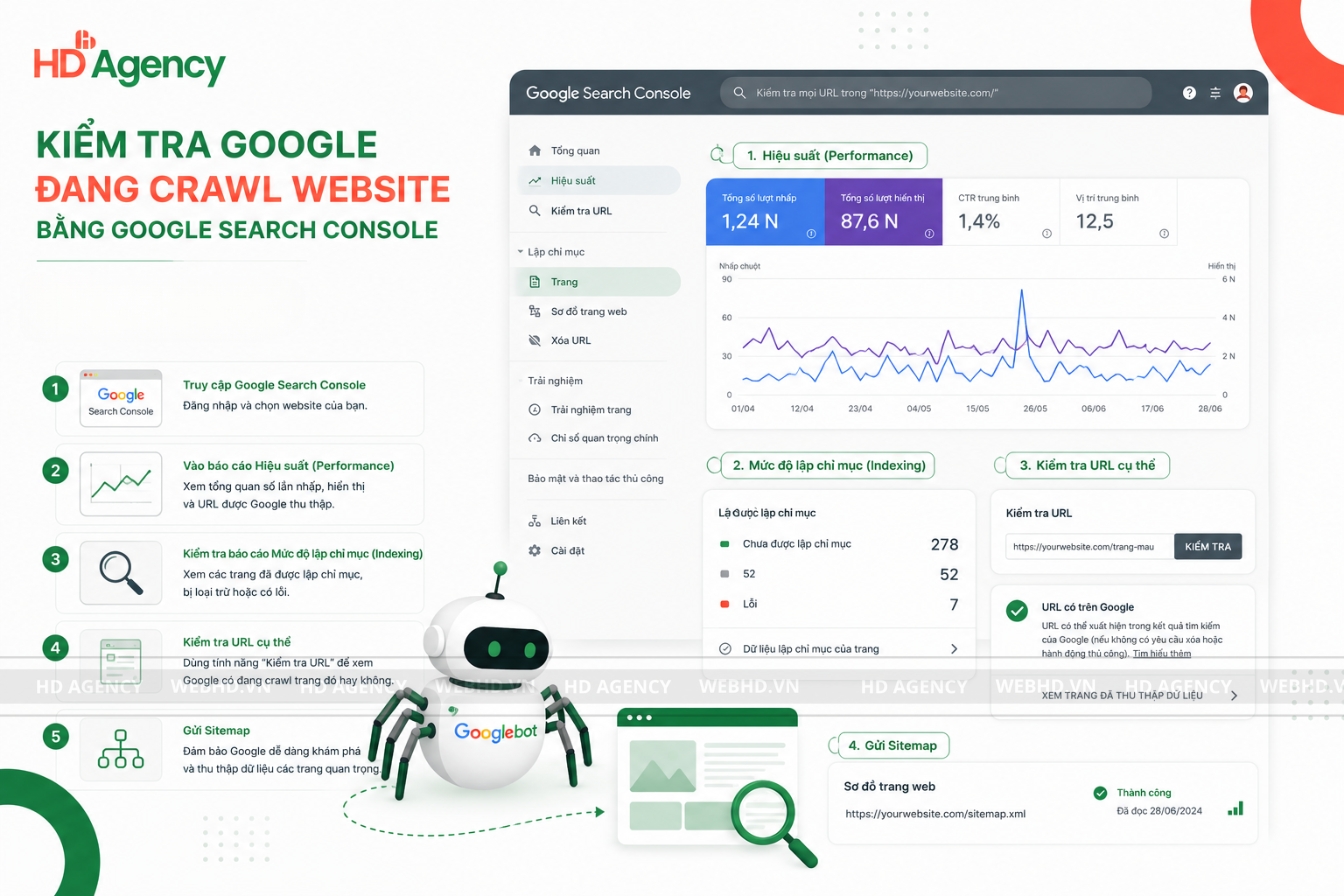
Google Search Console
Trong mục Page Indexing và Crawl Stats, bạn có thể theo dõi:
- Số lượng trang được crawl.
- Tần suất Googlebot truy cập.
- Các lỗi crawl.
- URL bị chặn.
Screaming Frog SEO Spider
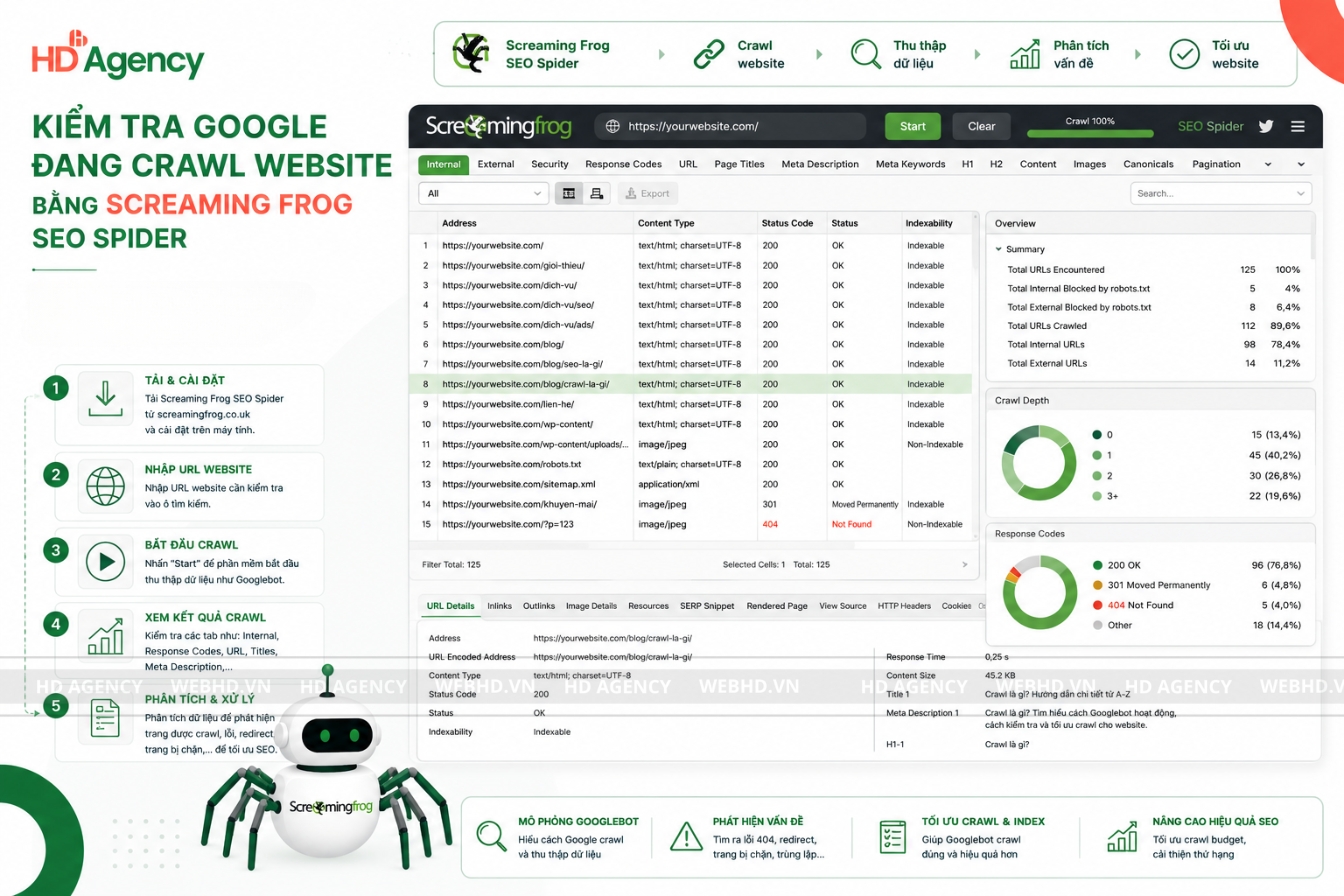
Công cụ này mô phỏng hoạt động của crawler để phát hiện:
- Link lỗi.
- Redirect.
- Canonical.
- Meta Robots.
- Cấu trúc Internal Link.
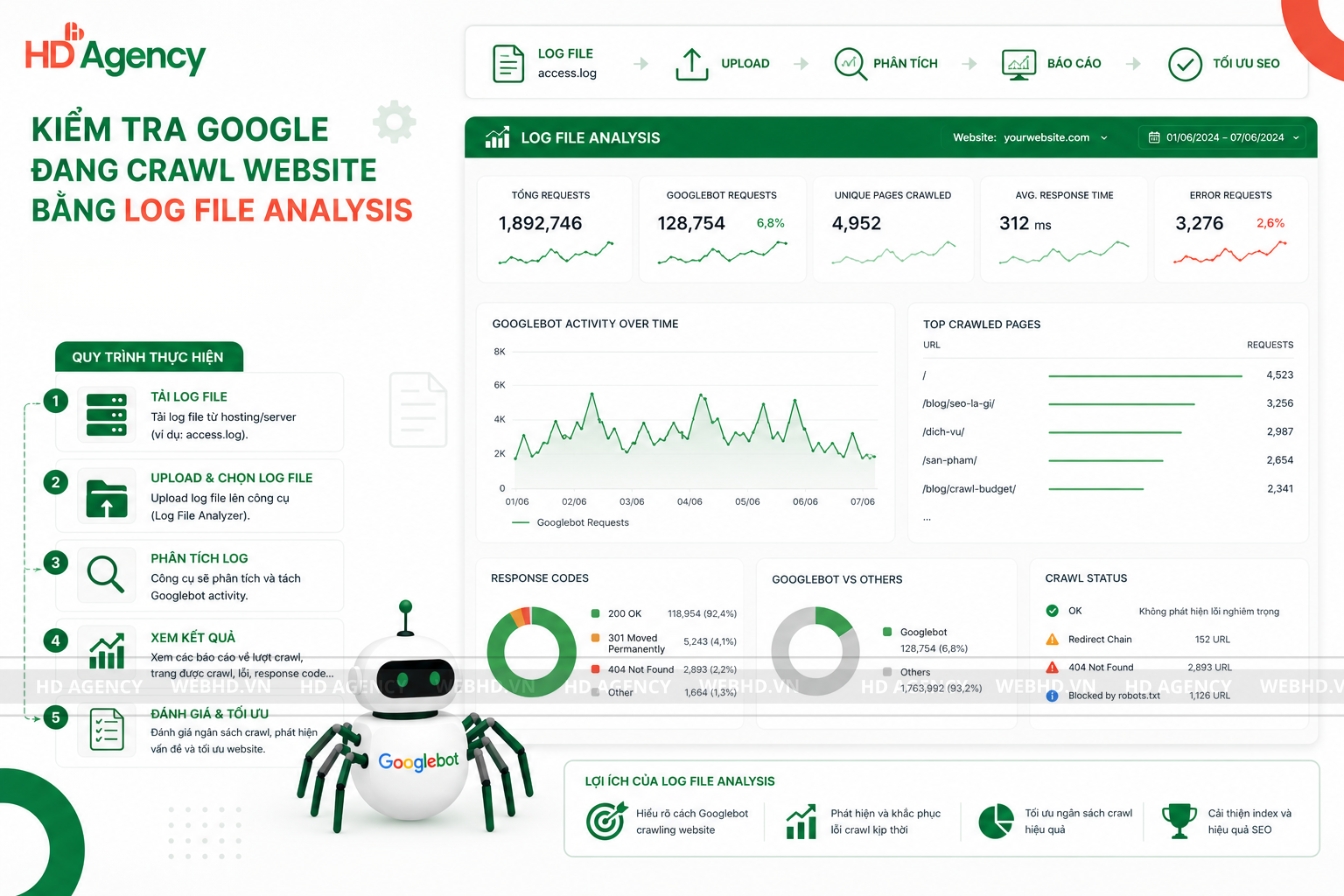
Log File Analysis
Phân tích Log Server giúp biết chính xác:
- Googlebot đã truy cập URL nào.
- Thời điểm crawl.
- Tần suất crawl.
- HTTP Status trả về.
Đây là phương pháp thường được áp dụng với các website có lượng URL lớn hoặc cần tối ưu SEO kỹ thuật chuyên sâu.
Tối ưu Crawl Budget, robots.txt hay XML Sitemap, các yếu tố liên quan đến hoạt động của website cũng cần được quan tâm để xây dựng một hệ thống vận hành hiệu quả. Nếu muốn hiểu rõ hơn về cách website lưu trữ thông tin và hỗ trợ trải nghiệm người dùng, bạn có thể tìm hiểu thêm Cookie là gì. Nắm vững cả hai kiến thức sẽ giúp bạn có góc nhìn toàn diện hơn khi triển khai SEO và quản trị website.
Những câu hỏi thường gặp về Crawl
Website mới bao lâu Google sẽ crawl?
Không có thời gian cố định. Có website được crawl sau vài giờ, cũng có website mất vài ngày hoặc lâu hơn, tùy vào tín hiệu và mức độ khám phá của Google.
Có nên chặn toàn bộ trang có tham số URL?
Không phải lúc nào cũng nên. Cần đánh giá từng loại tham số để tránh chặn nhầm các URL mang giá trị SEO.
Google crawl nhiều có tốt không?
Google crawl thường xuyên là tín hiệu tích cực nếu website liên tục cập nhật nội dung chất lượng. Tuy nhiên, với các URL không quan trọng, việc bị crawl quá nhiều có thể làm tiêu tốn Crawl Budget.
Crawl có ảnh hưởng đến thứ hạng SEO không?
Có. Nếu Google không thể crawl hoặc crawl không hiệu quả, nội dung sẽ khó được index đúng thời điểm, từ đó ảnh hưởng đến khả năng hiển thị trên kết quả tìm kiếm.
Hiểu rõ crawl là gì giúp bạn nắm được cách Google tiếp cận và đánh giá website ngay từ bước đầu tiên. Tối ưu quá trình crawl không chỉ hỗ trợ Google thu thập dữ liệu nhanh hơn mà còn giúp phân bổ Crawl Budget hợp lý, hạn chế lãng phí tài nguyên vào những URL không mang lại giá trị SEO.